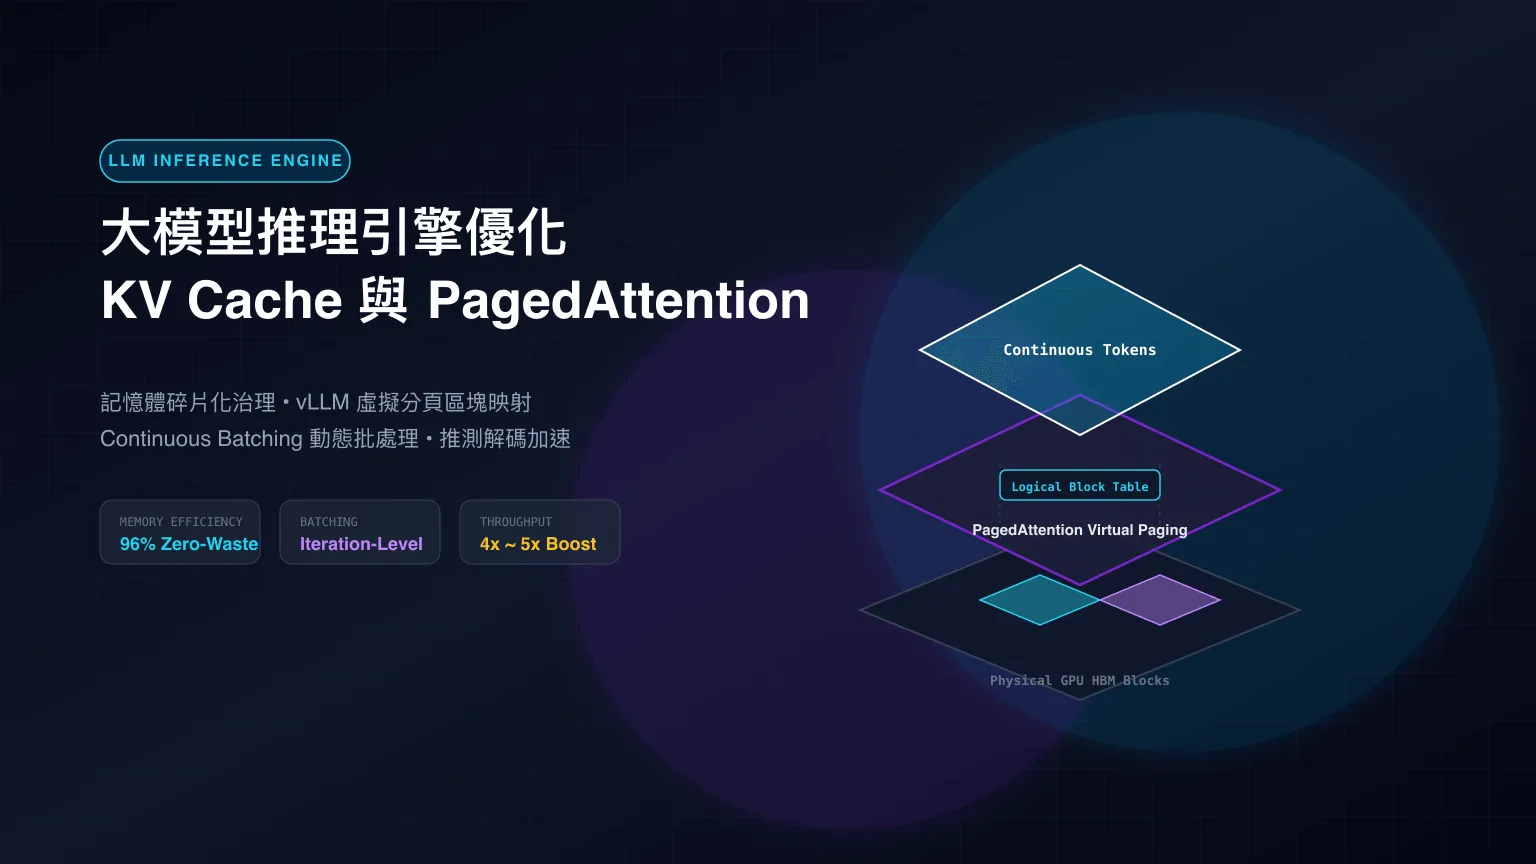
在生成式 AI 與大語言模型(LLM)落地生產環境的過程中,「推理效能與 GPU 顯存成本」 是決定業務能否盈利的生死線。
許多工程師初次部署開源大模型(如 Llama 3 70B 或 Qwen 2.5)時,常會發現:即使配備了昂貴的 8x H100 GPU 伺服器,當併發請求數(Concurrent Requests)稍一上升,系統就會因為顯存溢出(OOM, Out of Memory)而崩潰,或是每秒處理 Token 數(Tokens/sec)低得令人無法接受。
LLM 的自迴歸(Autoregressive)生成特性,決定了其推理過程包含兩個特性完全相反的階段:Prefill 階段與 Decode 階段。其中產生的 KV Cache 更是吞噬 GPU 記憶體的頭號元兇。
加州大學柏克萊分校發表的經典論文 vLLM: Efficient Memory Management with PagedAttention (SOSP 2023) 透過作業系統虛擬記憶體的分頁思想,徹底顛覆了 LLM 推理架構。
本文基於 vLLM 論文、Hugging Face TGI 與 ByteByteGo System Design 101,深度剖析大模型推理優化的核心演算法與工程實踐。
Prefill 與 Decode 階段
Prefill 屬於計算密集型,Decode 屬於記憶體頻寬受限。傳統靜態分配 KV Cache 造成 60%~80% 顯存碎片浪費。
vLLM 虛擬分頁映射
借鑒作業系統虛擬記憶體,以 16 Token 為單位動態分配物理區塊,支援 Beam Search 零拷貝共享,顯存利用率提升至 96%+。
Continuous Batching 與推測解碼
Iteration-level 動態批處理消除 Padding,搭配 Draft 小模型推測驗證,系統吞吐量暴增 4~5 倍。
一、Prefill 階段 vs. Decode 階段:兩種完全不同的效能瓶頸
Transformer 模型在生成文本時,每個 Request 都必須經歷兩個截然不同的計算階段:
1. Prefill 階段(首字生成階段 / Prompt Processing)
- 任務:接收使用者輸入的完整 Prompt(例如 2,000 字),計算所有輸入 Token 的 Self-Attention 矩陣,並生成第一個 Output Token。
- 瓶頸特徵:計算密集型(Compute-Bound)。所有輸入 Token 可以透過 GEMM(矩陣乘法)完全平行並發計算,GPU 運算核心(Tensor Cores)利用率接近飽和。
- 核心指標:TTFT(Time-to-First-Token,首字延遲)。
2. Decode 階段(自迴歸逐字生成階段 / Token Generation)
- 任務:每次將新生成的 1 個 Token 與過去所有的歷史 Token 結合,預測下 1 個 Token。
- 瓶頸特徵:記憶體頻寬受限(Memory-Bound)。每生成僅僅 1 個 Token,GPU 都必須從顯存(HBM)中完整載入數十 GB 的模型權重矩陣與全量歷史 KV Cache!
- 核心指標:ITL(Inter-Token Latency,詞間生成延遲) 與每秒整體吞吐量。
二、KV Cache 為何浪費 60% ~ 80% 的 GPU 顯存?
在 Attention 計算中:
Attention(Q, K, V) = softmax((Q * K^T) / sqrt(d_k)) * V在自回歸解碼(Autoregressive Decoding)過程中,每生成一個新 Token,模型需要與歷史上所有的 Token 計算注意力。為了避免重複計算歷史 Token 的 Key 和 Value 向量,系統會將歷史各層的 K 與 V 矩陣快取在顯存中——這就是 KV Cache。
1.2 KV Cache 顯存容量估算公式
每個 Token 所需的 KV Cache 顯存大小計算公式為:
KV_Size_Per_Token = 2 * n_layers * n_heads * d_head * precision_bytes以 Llama 3 70B(80 層、8 個 KV Heads、Head Dim 128、FP16 2 Bytes)為例:
- 單一 Token 的 KV Cache =
2 * 80 * 8 * 128 * 2 Bytes = 327,680 Bytes ≈ 320 KB。 - 若 Context 長度達到 8,192(8K),單一併發請求就需要佔用 2.56 GB 顯存!
- 若同時有 100 個併發請求,僅 KV Cache 就需要 256 GB 顯存,遠遠超過模型權重本身!
2. 傳統推理框架的碎片化危機(Fragmentation)
在 vLLM 出現前,傳統系統(如 Hugging Face Transformers / FasterTransformer)採用靜態連續記憶體分配:
- 內部碎片(Internal Fragmentation):由於無法預知用戶請求會生成多少字,系統必須預先為每個請求分配最大長度(如 Max-Seq-Len = 8K)。若用戶只生成了 200 字就結束,剩餘 7.8K 的顯存空間全部被白白浪費!
- 外部碎片(External Fragmentation):請求長短不一,不同長度的動態分配在顯存中產生大量無法利用的離散空洞。
- 保留碎片(Reservation Fragmentation):為未來可能生成的 Token 提前鎖定顯存配額。
三、vLLM 革命:PagedAttention 虛擬分頁區塊架構
vLLM 的核心突破在於:將作業系統管理記憶體分頁(Paging)的機制引入了 GPU 顯存管理。
1. Logical Block Table 映射機制
- vLLM 將每個序列的 KV Cache 邏輯上切分為固定大小的 Block(如每個 Block 容納 16 個 Tokens)。
- 物理顯存不再要求連續存放,而是劃分為一個個不連續的物理塊池(Physical Block Pool)。
- 透過 Block Table 記錄邏輯塊到物理塊的動態映射(類似 OS 的 Page Table):
2. 零拷貝分叉與共享(Copy-on-Write)
在平行採樣(Parallel Sampling,如一次生成 3 個回答)或 Beam Search 時,多個分支共享相同的 Prompt 前綴:
- 傳統做法:必須複製多份完整的 Prompt KV Cache。
- PagedAttention:多個邏輯序列直接指向相同的物理 Block,引用計數(Reference Count)加 1。
- 只有當某個分支開始生成不同的新 Token 時,才觸發 Copy-on-Write(寫時複製),節省高達 55% 以上的顯存!
四、Continuous Batching(持續動態批處理)
傳統批處理(Static Batching)必須等待批次中最長的請求生成完畢才能結束,導致短請求結束後 GPU 計算單元大量空轉等待(Padding Waste)。
Continuous Batching(迭代級動態調度) 徹底改變了調度粒度:
- 在每一次 Token 迭代(Iteration-Level)結束時,檢查是否有已完成的請求;
- 一旦請求完成,立即釋放其物理 Block,並在下一輪迭代中無縫插入新的請求。
- GPU 算力利用率達到 95% 以上,吞吐量提升 3 ~ 4 倍。
五、Speculative Decoding(推測解碼):打破自迴歸速度極限
Decode 階段每次 Forward 只能產生 1 個 Token。推測解碼(Speculative Decoding) 利用「大模型驗證比生成快」的數學特性打破這一瓶頸:
- Draft 小模型高速生成:使用輕量級模型(如 Llama-3-8B 作為 70B 的 Draft)快速推測生成 K 個 Token(例如 K = 5)。
- Target 大模型單次驗證:大模型在僅僅 1 次 Forward Pass 中同時評估這 5 個候選 Token 的條件機率分佈。
- 拒絕採樣(Rejection Sampling):
- 若前 3 個 Token 命中分佈,則全部接受;第 4 個若偏離則拒絕並即時修正。
- 數學嚴格證明:最終輸出文本的機率分佈與大模型單獨生成完全等價(Lossless Quality)。
- 效果:每次大模型前向傳播平均可產生 2 ~ 3 個 Token,端到端推理延遲降低 50% ~ 70%。
六、生產環境落地最佳實踐
- 量化加速(Quantization):採用 AWQ(Activation-aware Weight Quantization) 或 FP8 格式,將模型權重由 16 位元壓縮至 4/8 位元,大幅降低記憶體頻寬壓力。
- Chunked Prefill:將超長 Prompt 切片與 Decode 請求混合批處理,避免超長 Prompt 霸佔 GPU 導致短請求產生嚴重的 TTFT 尖刺。
- 前綴快取(Prefix Caching):在 Agent 或 RAG 場景中開啟
enable_prefix_caching=true,自動複用多輪對話中相同的 System Prompt 與知識庫檢索上下文。