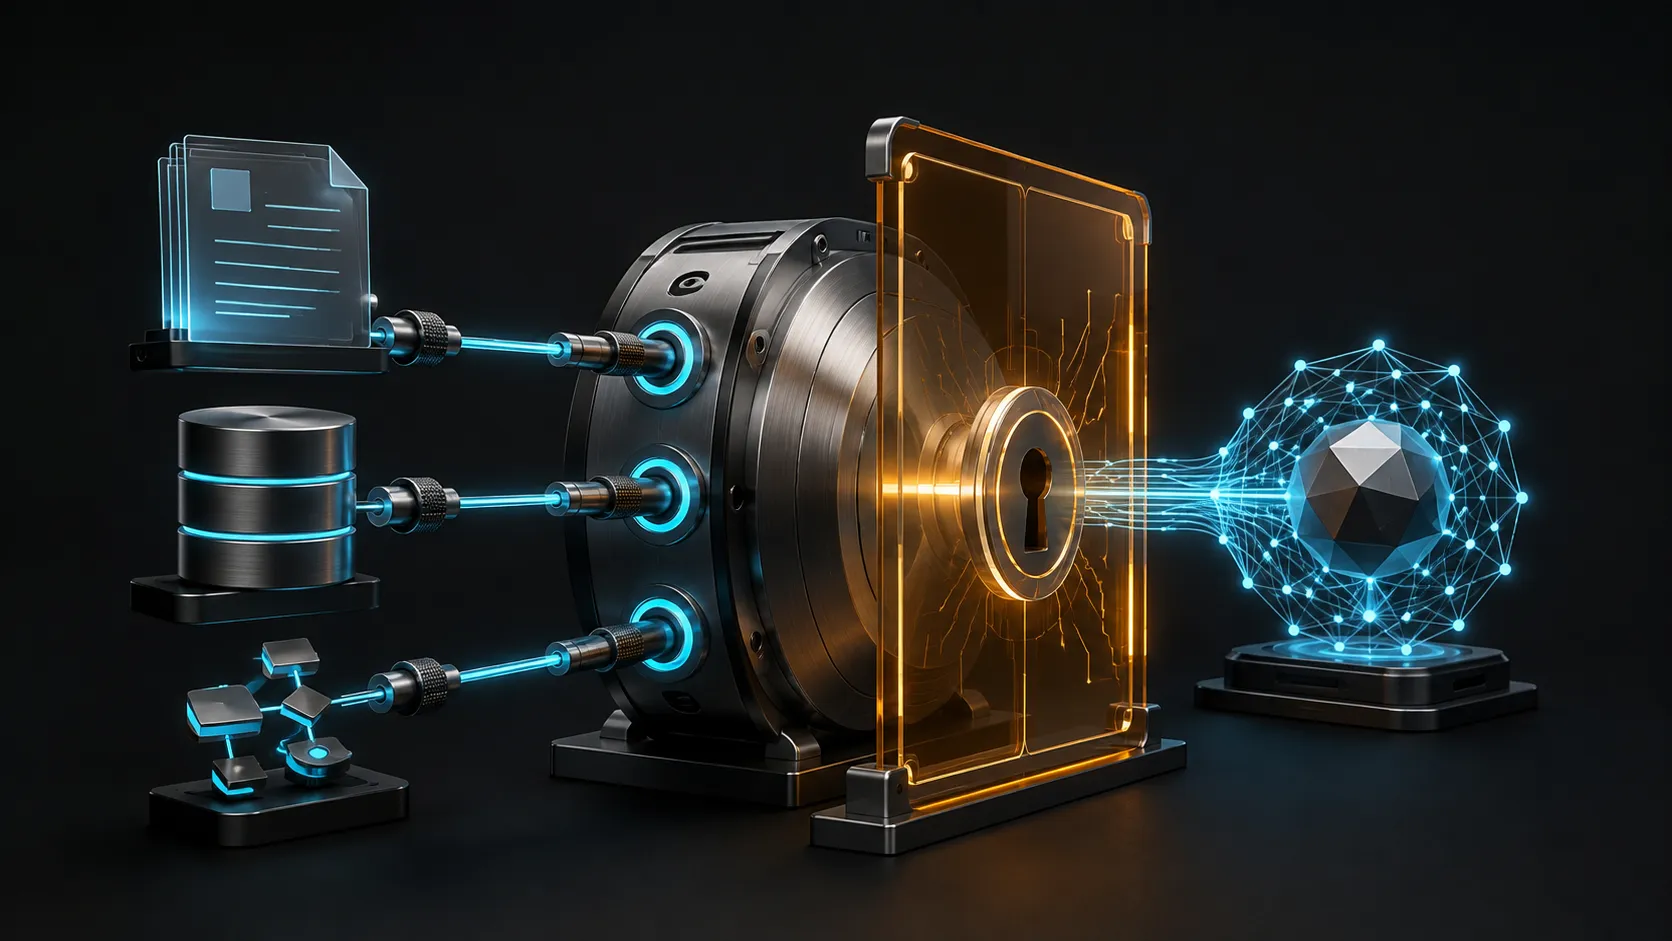
把 MCP 比作 AI 的 USB-C 是有用的入門說法:它讓 AI 應用以共同方式發現資料與工具,不必為每個宿主各做一次私有整合。@vicky_grok 的原始 X Article用這個比喻解釋 Host、Client、Server,以及 Resources、Prompts、Tools。
但把插頭插得進去,和允許它做任何事,是兩個問題。我的立場是:**MCP 應該是能力介面,不該被誤當成授權控制面。**第一個 MCP server 的成功標準不是「Agent 終於能碰到 production」,而是每一個可碰到的能力都有可見範圍、可拒絕動作與可回查結果。
先分清三種能力由誰控制
MCP 規格把三個 server primitive 排成很重要的控制層級:Prompts 由使用者選擇、Resources 由應用程式附加與管理、Tools 則可由模型依情境呼叫。它們不應共用同一種權限策略。
| 能力 | 誰決定使用 | 適合的第一個用途 | 不該直接推論 |
|---|---|---|---|
| Prompt | 使用者 | 固定的查詢或交接模板 | 選了模板就取得資料權限 |
| Resource | Host/應用程式 | 已篩選的文件或版本資訊 | 模型可任意讀取本機或雲端資料 |
| Tool | 模型可提出呼叫 | 受限的查詢或計算 | 模型可以代表人完成寫入 |
例如「查詢本週退款案件」可先是一個唯讀 tool;「將退款標記為已核准」則是不同的業務動作。不要用同一個 run_sql 或 call_api 入口期待 prompt 文字會永遠把兩者分開。介面一旦把讀寫混在一起,host 最後只能選擇每次都問,或一次全部放行。
Server 是 adapter,不是安全魔法
MCP server 確實可把工具藏在模型與底層系統之間,但它只在把限制實作進去時才是一道邊界。官方 Tools 規格要求 server 驗證輸入、實作存取控制、限流與清理輸出;同一份規格也建議 client 在敏感操作前要求使用者確認、展示工具輸入、驗證結果、設定 timeout 並記錄使用情形。
這表示「server 只接受 SELECT」是合理的第一步,卻不是完整政策。它還要限制可查的 schema 或 view、使用獨立唯讀帳號、遮罩敏感欄位、設定 query timeout 與 row limit;否則模型雖然不能寫入,仍可能把不應出現在 context 的資料帶回來。
tool: refunds_search
identity: agent_refunds_readonly
allowed_data: refund_summary_view
input:
  status: [pending, approved, rejected]
  created_after: ISO-8601 date
limits:
  max_rows: 100
  timeout_ms: 3000
requires_confirmation: false
audit:
  record: actor, request_id, filters, row_count, result_hash
上面的限制刻意沒有提供任意 SQL、客戶 email 或寫入權限。等到確定需要執行退款,再新增另一個名稱清楚、輸入狹窄的 write tool,並讓 host 要求人工核准。這比把一支萬用工具包成「請小心使用」少得多,也更能被測試。
不要把傳輸方式誤認成資料治理
本機的 stdio server 常被說成資料「不離開電腦」,但那不是 MCP 可以單獨保證的事。資料是否外送取決於 host 如何把 tool result 放進模型 context、模型服務在哪裡執行、server 又呼叫了哪些上游服務。先畫出實際資料路徑,再決定資料分類、網路出口與核准點。
遠端部署也不必沿用過時的心智模型。MCP 在 2026-07-28 規格把核心改成可無 session 的 request/response,讓 request 能分散到一般 load balancer 後的任一實例;舊 HTTP+SSE transport 已進入棄用期。官方版本說明也指出新 header 可讓 gateway、rate limiter 或 WAF 依方法與 tool 名稱路由、授權與計量。這解的是可擴展性與可觀測性,沒有取代每個 tool 自己的資料與業務授權。
將第一次導入縮成一條可驗收路徑
不要先安裝一長串社群 server,再試著補上通用 guardrail。選一個低風險、唯讀、可量測的問題,例如查詢已去識別化的支援案件摘要,並把驗收條件寫在 server 外面:
- Tool schema 拒絕未宣告的 filter,且 server identity 無法讀取原始資料表。
- Host 在送出呼叫前顯示 filter 與資料範圍;對新增、修改、匯出等動作改為明確核准。
- 每次呼叫留下 request ID、操作者、輸入摘要、結果筆數與失敗原因;超時時標為未知,不盲目重試。
- 用一組允許與拒絕的請求驗證 server,並確認 log 不記錄 token 或資料內容。
這四件事比「已連上 MCP」更接近可用的完成定義。要理解 MCP 在更大的 Agent 技術棧裡處於哪一層,可接續閱讀 MCP + MHS 會成為 AI 作業系統嗎?;它說明協定介面之外,runtime 還要處理排程、復原與責任。
結語:把第一個 tool 當成權限設計題
MCP 降低的是整合摩擦,讓同一項能力可以被不同 AI 應用發現與呼叫;它沒有替你決定哪個使用者、哪段資料、哪個動作值得被允許。
下一次要接 MCP 前,先拿掉萬用 tool,寫下第一條唯讀查詢的資料範圍與停止規則。能用一條明確、可拒絕、可稽核的路徑完成工作後,再擴充能力;這時 MCP 才是可重用的介面,而不是一次放大的權限洞。
若工具已具備明確授權,下一步是減少資料在模型上下文中的搬運。〈Pi 開始支援 MCP:工具接得上之後,還要能組合〉接著討論按需發現、結構化結果與 Codemode 的驗收方式。