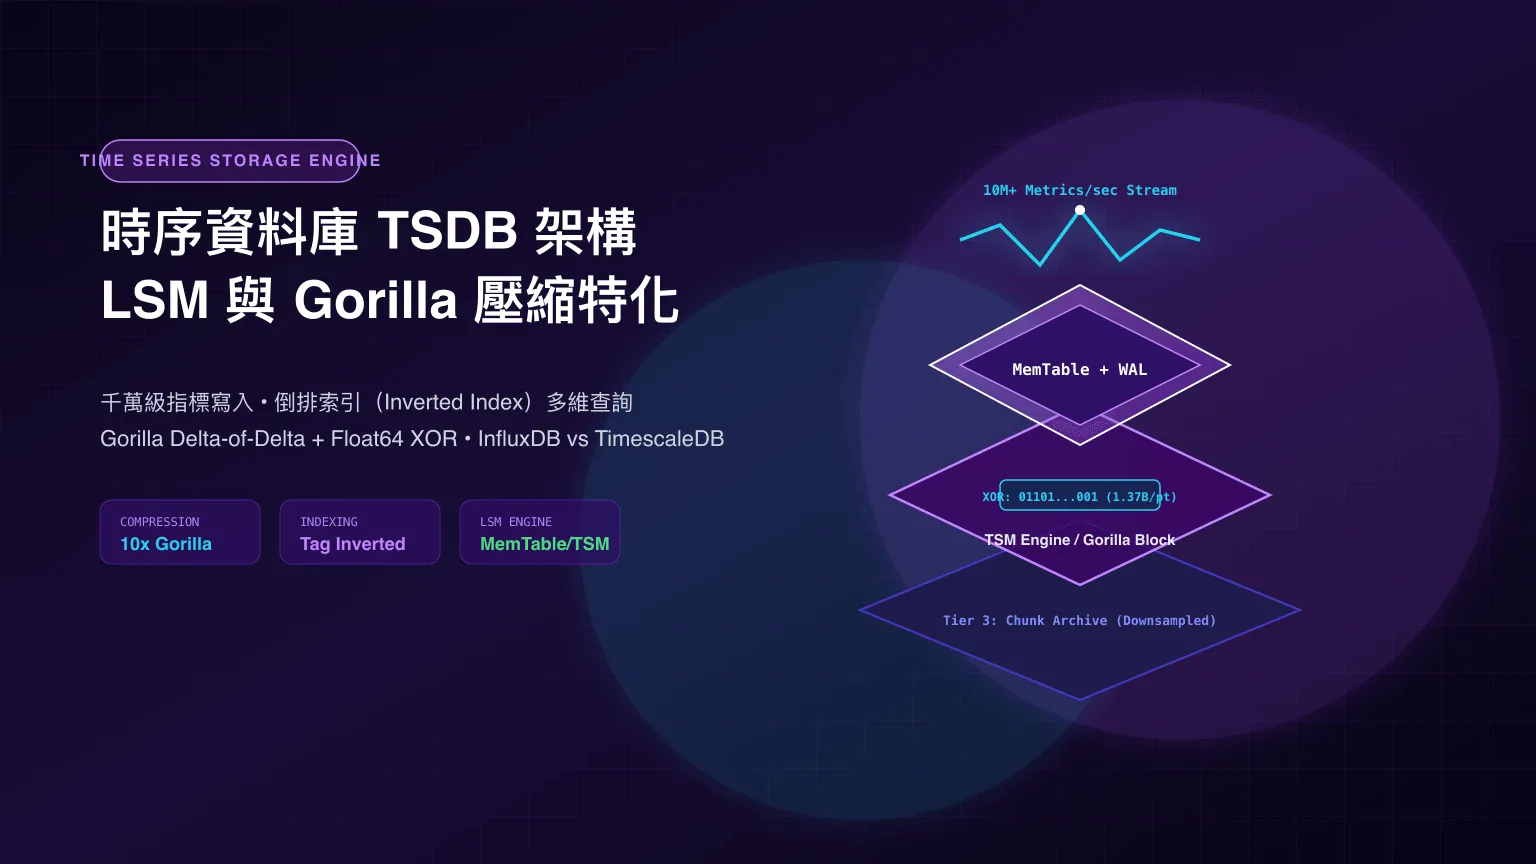
在現代雲端原生可觀測性(Prometheus、Grafana、Datadog)、IoT 物聯網遙測與金融高頻行情中,系統每秒需要接收數百萬至數千萬筆帶有時間戳的指標數據(Metrics Data Points)。
這類資料具有高度鮮明的特徵:
- 極致寫多讀少(95%+ 為寫入操作);
- 資料嚴格按時間單調遞增(Append-Only);
- 幾乎不發生隨機覆蓋更新(No In-place Updates);
- 隨時間推移,歷史資料價值急劇衰減(Hot/Cold Tiering)。
傳統基於 B+ Tree 的關聯式資料庫在這種持續高併發寫入下會迅速遭遇隨機 I/O 瓶頸與索引膨脹。因此,時序資料庫(TSDB, Time Series Database) 應運而生。
本文基於 Facebook 經典論文 Gorilla: A Fast, Scalable, In-Memory Time Series Database (VLDB 2015) 與 ByteByteGo System Design 101,深入剖析 TSDB 寫入管線、倒排索引與 Gorilla 極致壓縮演算法。
1. LSM / TSM 寫入管線
WAL 保障資料不丟失,MemTable 記憶體內排序,Flush 順序寫入磁碟 Chunk,透過 Compaction 降採樣合併。
2. Tag 倒排索引 (Inverted Index)
將標籤鍵值對映射為 Series ID 列表,利用 Roaring Bitmap 進行高速布林交集查詢。
3. Facebook Gorilla 演算法
時間戳 Delta-of-Delta 與 Float64 數值 XOR 壓縮,將原始 16 Byte/點 壓縮至 1.37 Byte/點,壓縮比達 10 倍以上。
一、為什麼傳統 B+ Tree 在時序場景下崩潰?
關聯式資料庫(如 MySQL / PostgreSQL)普遍採用 B+ Tree 作為索引結構。
在時序場景中,每一筆寫入都是 (metric_name, timestamp, value, tags)。當建立索引時:
- 隨機 I/O 與頁分裂(Page Splits):多個不同的時間序列(Time Series)交錯寫入,導致 B+ Tree 葉節點在記憶體中不斷發生隨機尋址與分裂,磁碟寫放大(Write Amplification)極其嚴重。
- 鎖爭用與高開銷:B+ Tree 為了維護樹的平衡,寫入時需要對節點加鎖(Latch),無法充分發揮多核心平行寫入能力。
二、TSDB 儲存引擎:LSM-Tree 與 TSM 特化
為了最大化寫入吞吐量,現代 TSDB(如 InfluxDB TSM、Prometheus TSDB)全面轉向 LSM-Tree(Log-Structured Merge-tree) 架構:
- WAL(預寫日誌):所有寫入直接順序追加到磁碟末尾,提供崩潰恢復保證,將隨機 I/O 轉化為極限順序 I/O。
- MemTable(記憶體跳躍表):資料在記憶體中按
SeriesKey + Timestamp排序。 - Immutable Chunk Flush:當 MemTable 達到大小閾值時,轉為不可變塊並 Flush 到磁碟,產生連續存放的時序 Chunk 檔案。
三、多維標籤檢索:Tag 倒排索引(Inverted Index)
在 Prometheus 或 InfluxDB 中,一個指標通常由多個 Tag 標籤定義:
http_requests_total{method="POST", handler="/api/pay", status="500", region="us-east"}用戶常發起多維度過濾查詢:WHERE method="POST" AND status="500"。
1. Series Key 到 Series ID (SID) 的映射
TSDB 將 metric_name + sorted(tags) 進行雜湊,分配一個全域唯一的整數 Series ID (SID)。
2. 倒排索引矩陣
系統為每個 Tag 鍵值對建立倒排索引清單:
3. Roaring Bitmap 實現百萬級位元交集
當執行 method="POST" AND status="500" 時,TSDB 透過 Roaring Bitmap 進行硬體加速的位元交集運算(AND bitwise operation),在**微秒級(microsecond)**內鎖定符合條件的 SID 集合 [105, 203],再直接精確尋址讀取對應的時序資料塊。
四、Facebook Gorilla 核心壓縮演算法(VLDB 2015)
時序資料點由兩部分組成:(Timestamp 64-bit, Value Float64 64-bit),原始大小為 16 Bytes / 點。
Facebook 在 2015 年發表的 Gorilla 論文中提出了革命性的雙重壓縮演算法,將平均每點大小壓縮至 1.37 Bytes,實現了 12 倍以上的記憶體節省。
1. 時間戳壓縮:Delta-of-Delta(二階差分編碼)
通常指標採樣是等間隔的(例如每 10 秒採樣一次)。
令時間序列為 t0, t1, t2, …:
- 一階差分:D1 = t1 - t0 = 10
- 二階差分(Delta-of-Delta):D = (tn - tn-1) - (tn-1 - tn-2)
在絕大多數週期性監控場景中,D = 0 佔比超過 90%,每個時間戳僅需 1 個 bit 即可完成儲存!
2. 浮點數值壓縮:Float64 XOR 演算法
相鄰採樣點的浮點數值(如 CPU 使用率 55.42% ➔ 55.45%)在 IEEE 754 二進位表示中,符號位、指數位以及大部分高位尾數是完全相同的。
令當前值 Vn 與前值 Vn-1 進行 XOR 運算:X = Vn XOR Vn-1。
透過 XOR 消除連續數值冗餘,浮點數平均大小由 8 Bytes 驟降至 1.37 Bytes。
五、主流 TSDB 架構選型對比:InfluxDB vs. TimescaleDB
| 架構維度 | InfluxDB (TSM / IOx) | TimescaleDB (PostgreSQL Extension) |
|---|---|---|
| 底層引擎 | 自研 TSM (LSM 變種) / Apache Arrow (IOx) | PostgreSQL 核心 + Hypertables 分區 |
| 查詢語言 | Flux / InfluxQL / SQL (v3) | 標準 SQL (完整支援 JOIN、CTE、視窗函數) |
| 寫入吞吐量 | ⭐️⭐️⭐️⭐️⭐️ (極高,專為寫入優化) | ⭐️⭐️⭐️⭐️ (極高,Chunk 空間分區) |
| 關聯查詢 (JOIN) | 較弱,不擅長複雜關聯 | ⭐️⭐️⭐️⭐️⭐️ (完整享用 Postgres 生態) |
| 儲存成本 | 極低(Gorilla + Parquet 列存) | 較低(內建 Chunk 等級透明壓縮) |
| 最佳適用場景 | 純監控指標、IoT 遙測、日誌時序 | 既需要時序高寫入、又需與業務資料庫關聯分析 |
六、工程總結與落地實踐
- 寫入管線一律走順序追加:拒絕隨機原地更新,利用 LSM-Tree / Chunk 分層將寫入放大降至最低。
- 嚴格控制 Tag 標籤基數:在 API Gateway 與 Ingestion 邊界防禦高基數標籤,防止倒排索引 OOM。
- 配置階層式降採樣(Downsampling Rollup):
- 原始精確度(10s)保存 7 天;
- 5 分鐘 Rollup 降採樣保存 30 天;
- 1 小時 Rollup 降採樣歸檔至物件儲存(S3)保存 1 年以上,實現儲存成本與查詢效能的完美平衡。