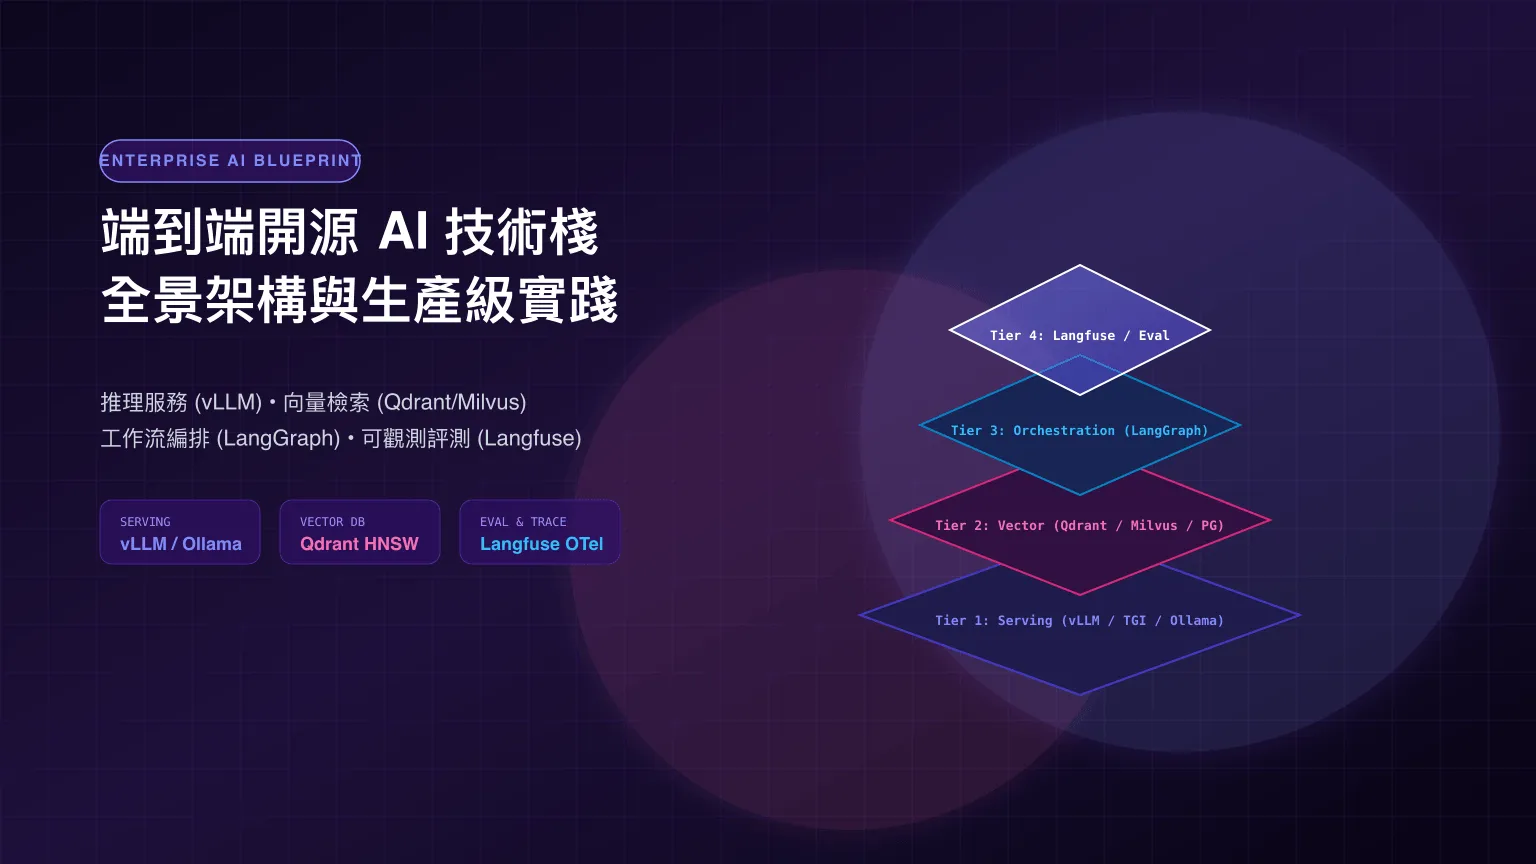
隨著開源大語言模型(如 Meta Llama 3、Qwen 2.5、DeepSeek-V2)在推理能力上迅速逼近閉源頂級模型,越來越多企業出於資料隱私安全、合規監管(GDPR/HIPAA)、深度客製化微調以及長期成本可控的考量,選擇在私有雲或地端機房建構專屬的 開源 AI 技術棧(Open Source AI Stack)。
然而,構建一套能夠支撐百萬級用戶、高可用且具備企業級可觀測性的私有化 AI 平台,絕非單純拉取一個 Docker 映像檔那麼簡單。
整個架構橫跨模型服務層(Serving)、向量儲存與檢索層(Vector DB)、工作流與 Agent 編排層(Orchestration),以及可觀測性與評測層(Observability & Eval) 四大核心支柱。
本文基於 ByteByteGo System Design 101 與業界前沿開源實踐,系統性梳理企業端到端開源 AI 技術棧的架構藍圖。
1. 模型推理層 (vLLM / Ollama)
支援多 GPU 張量平行與 PagedAttention 顯存管理,提供高吞吐、低延遲的 OpenAI 相容服務。
2. 向量檢索層 (Qdrant / Milvus)
億級 HNSW 索引與 BM25 混合檢索,為 Agent 與 RAG 提供精確知識召回與語義記憶。
3. 工作流編排 (LangGraph / MCP)
基於狀態圖(StateGraph)構建循環 Agent、工具調用沙盒與多智能體協同。
4. 可觀測與評測 (Langfuse / Ragas)
OTel 全鏈路追蹤 Token 消耗與延遲瀑布圖,透過 RAG Triad 自動評測防禦幻覺。
一、企業級開源 AI 技術棧全景分層
二、第一支柱:模型服務層(Model Serving)
模型服務層的核心任務是在保證低延遲的前提下,最大化 GPU 硬體吞吐量:
- 生產級高併發首選:vLLM / TGI(Text Generation Inference)
- 分散式平行推理:支援 張量平行(Tensor Parallelism, TP) 與 流水線平行(Pipeline Parallelism, PP),可將 70B/405B 超大模型分片跨多張 GPU 運算。
- PagedAttention 與 Continuous Batching:將顯存碎片率降至 4% 以下,系統吞吐量提升 4 倍以上。
- OpenAI 相容協議:提供標準的
/v1/chat/completions與串流 SSE(Server-Sent Events)接口。
- 本機與邊緣輕量選型:Ollama / llama.cpp
- 基於 GGUF 格式與 4-bit / 8-bit 量化(K-Quants),適合開發者本機測試、內網邊緣伺服器快速部署。
三、第二支柱:向量檢索與記憶層(Vector Storage)
檢索增強生成(RAG)與 Agent 長期記憶的品質,直接取決於向量資料庫的選型與索引策略:
| 技術選型 | 底層技術與特色 | 適用資料規模 | 最佳應用場景 |
|---|---|---|---|
| Qdrant | Rust 開發、高效能 HNSW、原生支援 Payload 過濾 | 數千萬 ~ 數億級 | 企業級高併發 RAG、複雜 Metadata 過濾 |
| Milvus | 雲端原生分散式架構、計算儲存分離 | 數億 ~ 數十億級 | 超大型海量資料湖、跨節點彈性擴縮 |
| pgvector | PostgreSQL 原生外掛、ACID 事務支援 | 數百萬級以內 | 原本即使用 Postgres、拒絕增加新維運組件 |
混合檢索(Hybrid Search)黃金組合
生產環境切忌「純向量餘弦相似度檢索」,容易在型號代碼、專有名詞(如 CVE-2024-38077)上失真。
- 最佳實踐:稠密向量(Dense Embedding,語義理解) + 稀疏檢索(BM25 / SPLADE,精準關鍵字),再透過 BGE-Reranker 進行交叉重排,準確率可提升 35% 以上。
四、第三支柱:工作流與 Agent 編排層(Orchestration)
在複雜業務場景中,單純的 Prompt 呼叫已無法滿足需求:
- LangGraph 狀態機編排:
- 採用 StateGraph(有向圖狀態機) 管理複雜業務流,天然支援循環迭代、分支判斷、多 Agent 協作與 Human-in-the-loop 人工介入審批。
- MCP(Model Context Protocol)標準化:
- 採用 Anthropic 推出的開源協議,將資料庫、企業內部 API 與工具封裝為標準化 Server,讓任何 Agent 都能即插即用。
五、第四支柱:可觀測性、評測與安全防護(Observability & Eval)
「無法測量,就無法優化。」生產環境必須對每一次 LLM 呼叫建立全鏈路監控:
1. 全鏈路追蹤:Langfuse / Arize Phoenix
- OpenTelemetry 整合:自動採集每一次 Request 的 Prompt、Completion、Token 消耗量、單步延遲瀑布圖。
- 成本歸因:精確統計不同部門、不同功能模組的 GPU / Token 成本。
- 使用者反饋閉環:綁定使用者按讚/按踩反饋與詳細對話歷史,作為後續 DPO / RLHF 微調的黃金資料集。
2. RAG 幻覺自動評測(RAG Triad)
透過 Ragas 或 DeepEval 工具對 RAG 生成結果進行自動化評估:
- Context Relevance(上下文相關性):檢索出的知識片段是否真正與使用者問題相關。
- Groundedness / Faithfulness(事實真實性):模型的回答是否完全忠實於檢索出的上下文,是否存在無中生有的幻覺。
- Answer Relevance(回答相關性):回答是否切中使用者問題核心。
六、企業私有化架構實戰總結
- 計算層標準化:使用 vLLM + Ray 構建彈性 GPU 推理資源池,支援模型熱更新與權重自動分發。
- 檢索層精細化:建立「混合檢索 + Reranker + 前綴快取」標準資料管線。
- 安全與治理閉環:在閘道邊界部署輸入輸出 Guardrails,在應用層接入 Langfuse 實施 100% 鏈路可觀測,打造高可靠、可審計的企業級 AI 基礎設施。