vLLM
2 篇文章
KV Cache 不是一個優化項:先分清楚你要減少的是容量、頻寬還是重複
從 Avi Chawla 的 KV cache 分類出發,將模型架構、token 保留、位元精度、配置重用與 offloading 變成一張 production capacity ledger,避免把不同代價誤當成同一個開關。
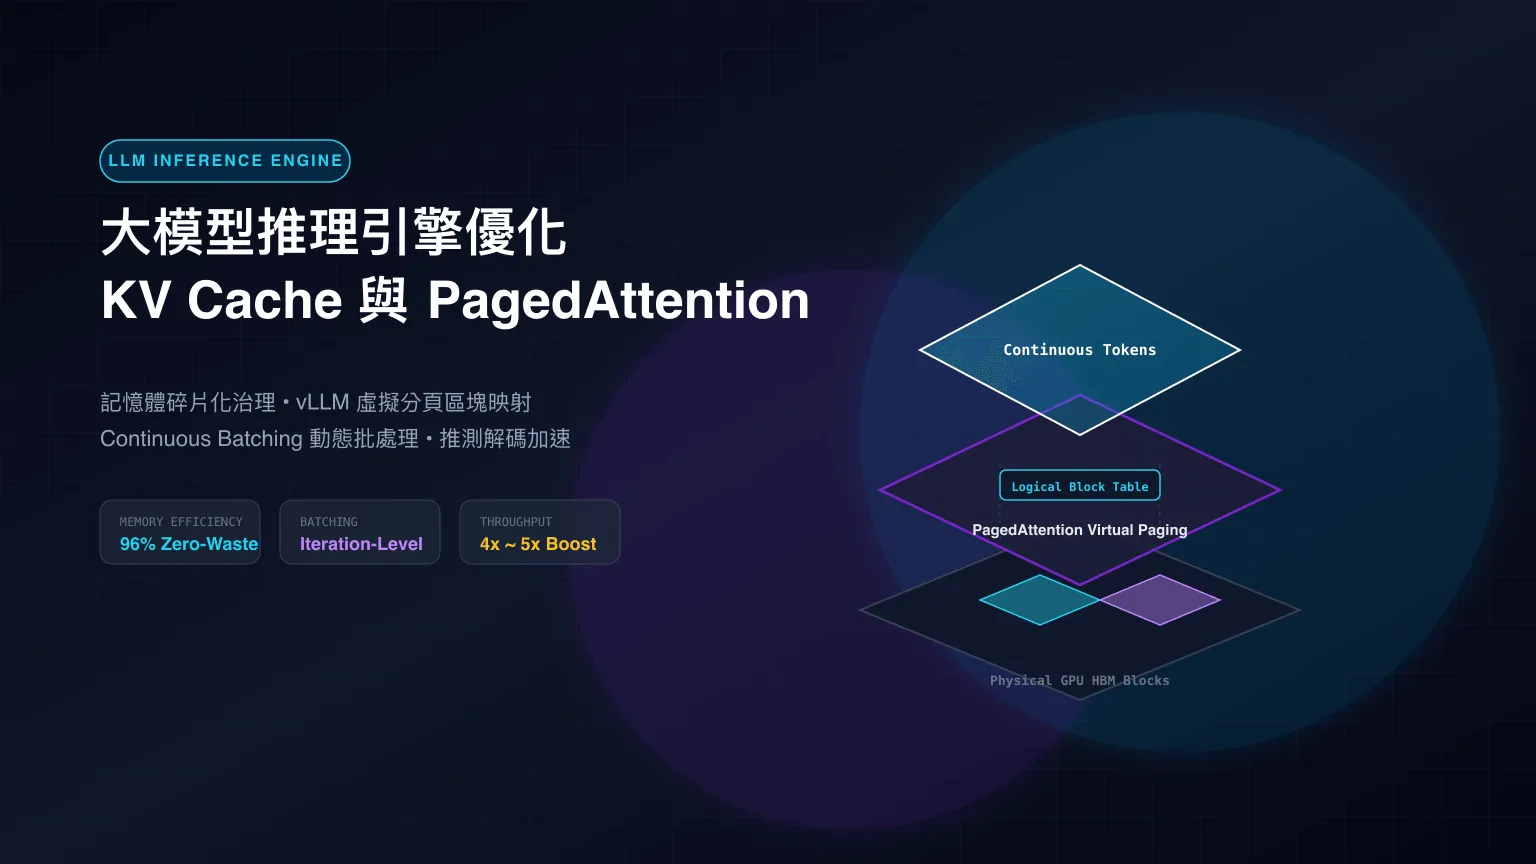
大模型推理引擎優化全景:KV Cache 記憶體碎片化、vLLM PagedAttention 與推測解碼實戰
深度拆解 LLM 大語言模型推理加速與顯存優化核心技術:剖析 Prefill 與 Decode 階段的計算與記憶體瓶頸;詳解 KV Cache 為何浪費 60%~80% 顯存;深入 vLLM PagedAttention 虛擬分頁區塊映射與零拷貝分叉;解析 Continuous Batching(持續批處理)與 Speculative Decoding(推測解碼)的吞吐翻倍實踐。