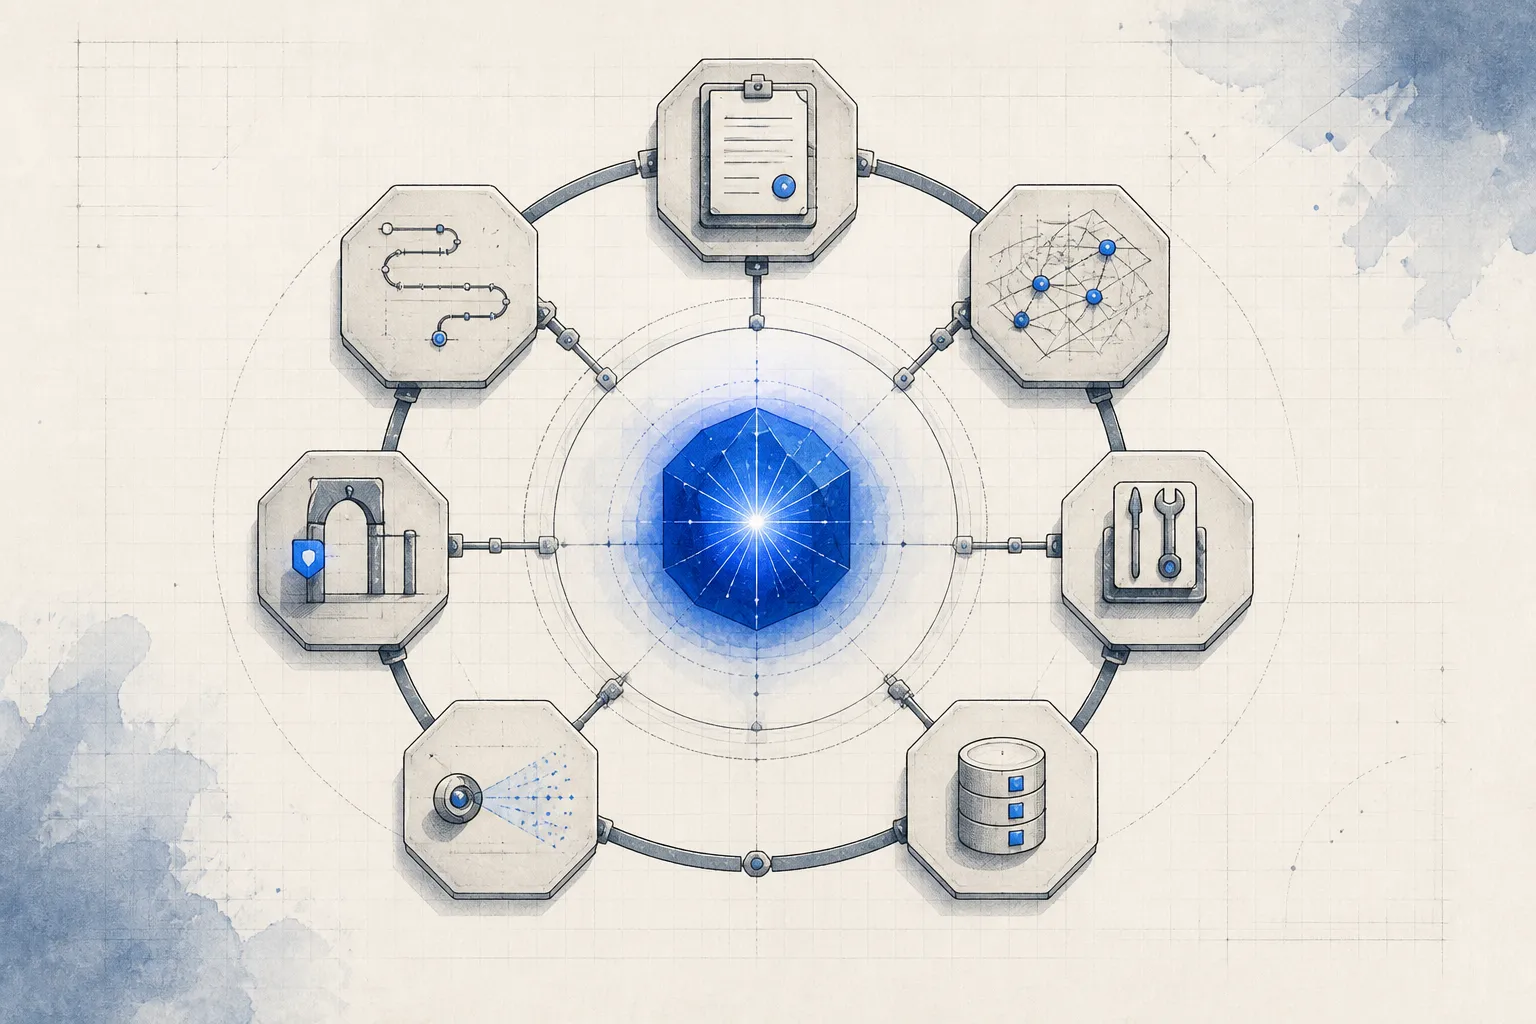
Agent 忘記決策、選錯工具、略過驗證,或在同一個錯誤裡反覆打轉時,我們很容易先改 prompt,再換模型,最後增加 context window。這些調整有時有效,卻也可能只是在修飾症狀。
@0xwhrrari 的〈Harness Engineering: How to Build AI Agents That Don’t Fall Apart〉與 @iiiichigo_chan 的〈Harness Engineering: Build a Reliable AI Agent in 6 Layers〉都提出另一個診斷角度:模型只是推理引擎;真正決定 Agent 是否可靠的,是包住模型的執行環境,也就是 harness。
這不是替 prompt engineering 換一個新名字。Prompt 決定「如何描述任務」,harness 則決定「任務在哪個世界裡執行」:模型能讀什麼、能改什麼、哪些狀態會留下、用什麼證據驗收、風險由誰核准,以及失敗後如何復原。
同一顆腦,放進不同世界
同一個模型放在聊天框裡,主要產物是回答。把它放進 repository,提供 terminal、tests、browser、project memory、隔離環境與 review loop,它才有機會交付可驗證的軟體。
模型權重沒有因此改變,改變的是模型與真實世界之間的介面。
OpenAI 在整理 Codex 的 agent loop 時,也把 harness 描述成協調使用者、模型與工具的核心:模型提出工具呼叫,環境執行後把結果放回 context,再讓模型決定下一步。這表示一次 Agent 執行不是單次生成,而是一個由環境控制的回饋迴圈。OpenAI:Unrolling the Codex agent loop
Context、state 與 memory 不是同一個抽屜
@Nikki Siapno把 Agent 濃縮成一個 Context → Reason → Act → Observe → Update → Repeat 的迴圈:harness 在每輪組裝資訊、呼叫模型、執行工具,並把結果帶進下一輪。這是解釋系統的實用模型,不是唯一的架構標準;但它剛好點出一個常被混在一起的邊界。
| 名稱 | 它回答的問題 | 典型內容 |
|---|---|---|
| Context | 模型這一輪能看見什麼? | 任務、相關文件、工具結果與被選取的記憶 |
| State | 任務目前進行到哪裡? | 已完成步驟、重試次數、待處理項目、預算與狀態 |
| Memory | 什麼資訊值得跨輪或跨 session 保留? | 可檢索的決策、偏好、知識、來源與有效期限 |
記憶被寫入,不代表它應自動進入下一輪 context;state 也不應只藏在對話歷史裡。前者需要依任務相關性取回,後者需要讓 harness 能檢查、更新與交接。否則長 context 會塞進過期資料,跨 session 任務又會遺失已完成的工作。更完整的記憶生命週期可參考 Memory Engineering。
Oracle 對 agent loop 的說法與此一致:harness 每輪組裝 instructions、conversation state、retrieved memory 與工具輸出,再由終止檢查決定是否繼續;模型不再呼叫工具,不等於使用者目標已完成。Oracle:The Agent Loop Decoded
先找第一個偏離點,不先換模型
@nyk 的〈Stop Upgrading the Model. Fix the Harness.〉把這個判斷變成較可操作的問題:任務第一次偏離預期,是在模型判斷、context、工具輸出、環境,還是驗證時發生?這是作者提出的診斷框架,不是已被普遍驗證的標準;但它能避免把每次失敗都預設成模型能力不足。
例如,模型因為拿不到目標檔案而改錯位置、工具吞掉 stderr、測試本身無法拒絕錯誤結果,或乾淨環境下無法重現成功,第一個故障點分別落在 context、工具、驗證與環境邊界。先換更強的模型,可能只會讓它更有說服力地跨過同一個壞邊界。
每次失敗只要留下下列最小紀錄,就能把「該換模型嗎」改成可被推翻的假說:
expected: 測試拒絕錯誤的公開輸出
firstDivergence: 測試只檢查 HTTP 200,沒有檢查內容
evidence: CI 輸出與最小重現
owner: verification
hypothesis: 補上 assertion 後可攔下同類錯誤
falsifier: 在乾淨環境重跑仍讓錯誤輸出通過找到偏離點後,還要把修正送到造成它的責任面。@iiiichigo_chan 的六層指南提供了四種故障到永久修正的對應:
- Context 缺漏:補上專案地圖或按需檢索來源。
- 工具契約不清:修正輸入 schema、逾時與結構化錯誤回應。
- 權限護欄缺漏:在模型之外新增 policy check。
- 驗證太弱:把漏掉的反例加入 regression test。
這是定位修復方向的分類法,不保證涵蓋所有根因。若 trace 還不足以歸因,就保留證據並升級處理,不要硬套類別。
這張卡不需要保存模型的思考過程;它只保存可稽核的外部證據與下一個檢查。OpenAI 對 Codex 的回顧同樣把環境規格、工具與可讀性視為 agent 能力的一部分,而非事後附加的 prompt。OpenAI:Harness engineering
一個 production harness 要做的七件事
兩篇原文對同一套邊界採用不同粒度:一篇整理成七項工作,另一篇濃縮成六層。本文把六層中的「有權限邊界的工具閘道」拆成工具契約與權限控制兩個責任,因此列為七個控制面;這是責任切分不同,不是兩套架構。以下不是產品採購清單,而是七個需要有人負責的控制面。
1. 把需求變成任務契約
「幫我把這個功能做好」不是可驗收的工作單位。Agent 動手前,至少要固定四件事:目標、不能破壞的條件、完成標準,以及必須留下的證據。
契約的價值不是寫更多文件,而是防止任務在執行中悄悄改義。否則 Agent 很可能完成另一件相近的事,最後仍宣告成功。
2. 給地圖,不要塞整本手冊
Agent 需要知道專案的邊界、入口、驗證命令與文件位置,但不需要每次都把所有規格塞進 context。
根目錄指南應像索引:告訴 Agent 去哪裡找答案。細節則靠近所治理的程式碼或工作流程,需要時再載入。Anthropic 對 context engineering 的建議也是保留高訊號內容,搭配即時檢索、摘要與外部筆記,而不是無限制擴張 prompt。Anthropic:Effective context engineering for AI agents
3. 只暴露正確的工具
工具不是按鈕清單,而是模型接觸真實世界的 API。可靠的工具要有清楚用途、明確輸入、可預期輸出、失敗狀態與權限邊界。
如果一個工具回傳大量無關資料,或成功與失敗長得一樣,模型就必須猜測剛才發生了什麼。Anthropic 的工具設計經驗同樣強調單一責任、清楚參數、錯誤處理與精簡回應,並以 evaluation 驗證工具是否真的容易被 Agent 使用。Anthropic:Writing effective tools for AI agents
4. 把記憶外部化成持久狀態
對話不是 system of record。決策、產物、失敗原因與未解風險若只存在 context window,下一次 session 得到的只是失真摘要。
長任務至少要留下可被新 session 讀懂的進度檔、git history、測試結果或結構化狀態。Anthropic 在長時間 Agent 實驗中,使用初始化 Agent、進度檔、啟動腳本與 git 紀錄,讓新的 context window 能接續前一輪工作。Anthropic:Effective harnesses for long-running agents
5. 先裝感測器,再增加自治
Agent 無法修正自己看不見的問題。Tests、linters、type checks、screenshots、logs、metrics 與 schema validators,會把「看起來可以」轉成可比較的證據。
這也是為什麼 coding Agent 相對容易形成閉環:程式輸出常能由自動測試回饋;但人類仍需檢查測試未涵蓋的整體需求。Anthropic:Building Effective AI Agents
6. 在模型之外強制權限
模型可以建議動作,harness 才能授權動作。讓同一個機率系統同時規劃、評估風險並執行不可逆操作,等於把安全邊界寫成一句「請小心」。
檔案、網路、憑證、部署與破壞性操作應分層控制,高風險動作要求明確核准。OpenAI 公開的 Codex 安全實務也把 sandbox、approval policy、網路白名單、憑證管理與 audit log 放在模型之外。OpenAI:Running Codex safely at OpenAI
7. 留下 trace,並支援局部復原
沒有 trace,失敗只是一個謎;有 trace,才知道錯在模型判斷、工具介面、缺少 context,還是驗收條件。
復原也應盡量局部化。工具失敗時重跑工具,測試失敗時修正該 slice,不要讓整個任務從頭生成。一次失敗若能補上一條測試、一個 schema 或一道權限護欄,就不只修好當次輸出,而是修掉一整類後續失敗。
把重要規則寫兩次
純文字規則會被忽略;只有機械檢查則讓人不知道限制的原因。較穩定的做法是把重要邊界寫兩次:
- 指南說明決策與原因。
- 測試、lint、schema、hook 或 permission gate 負責強制執行。
例如「公開文章一定要有 description」可以先寫進內容指南,再由 Content Collection schema 阻止缺欄位的 build。下一個 Agent 不必記得哪次事故促成這條規則,因為 harness 已替團隊記住。
「繼續做到成功」不是控制系統
長任務需要迭代,但無限重試會把錯誤變成成本。可控的 Agent loop 至少要有:
- 每輪可觀測的證據;
- 明確的重試上限或 token/時間預算;
- 能判斷是否有進展的停止條件;
- 超出權限或連續失敗時的升級路徑;
- 與 builder 分離的 evaluator,避免產出者自行核准。
模型可以決定如何修補局部缺口,harness 則決定是否允許下一輪。Anthropic 對 Agent 架構的建議也很務實:先用最簡單的方案,只有在 evaluation 顯示不足時才增加複雜度。Anthropic:Building Effective AI Agents
每次執行留一張 change receipt
最終答案可能隱藏一個壞掉的過程。除了產物,harness 應保留一張精簡的變更收據:
outcome: 已完成文章發布流程
changed:
  - src/content/blog/example.mdx
evidence:
  - pnpm check
  - pnpm test
decisions:
  - 使用既有 Content Collection,不新增 CMS
remaining_risk:
  - 尚未在正式網域做視覺檢查
這不是要求保存完整 chain of thought,而是記錄可稽核的動作、產物、驗證與剩餘風險。有了它,團隊才能比較模型升級前後的結果,定位 regression,也能讓下一個 session 從事實接手。
從能閉環的最小 harness 開始
Harness engineering 不等於先蓋平台。控制面應與失敗面成比例:
| 任務 | 最小可用 harness |
|---|---|
| 低風險、一次性文字工作 | 任務契約、來源檢查、人工 review |
| 可修改 repository 的短任務 | repo map、隔離權限、測試、diff review |
| 跨 session 的長任務 | 持久進度、checkpoint、預算、獨立 evaluator |
| 會連網或產生外部副作用 | allowlist、秘密隔離、動作前核准、audit log |
衡量這套環境是否真的減少交付成本時,不要只看 token 數、工具呼叫數或啟動任務數。@iiiichigo_chan 的原文提出觀察「驗收通過的產出 ÷ 人工審查分鐘」;這是作者建議的營運指標,不是經驗證的通用 benchmark。實際追蹤時,應固定驗收門檻,並同時看返工與漏出的缺陷,避免只靠降低審查力度讓比值變好。
OpenAI 在 agent-first codebase 的實作回顧中,也把早期進展慢歸因於環境規格不足,後續做法是把缺少的能力變得可被 Agent 讀懂,並由工具或檢查強制執行。OpenAI:Harness engineering: leveraging Codex in an agent-first world
結語:先找失敗的控制面
下次 Agent 重複失敗,不妨先停止微調 prompt 裡的形容詞,改問:
- 任務是否有不會漂移的契約?
- Context 裡是否只有當下需要的資訊?
- 工具是否回傳足以判斷成敗的結果?
- 狀態能否跨 session 保存?
- 測試與觀測是否能看見錯誤?
- 權限是否在模型之外執行?
- 失敗能否留下 trace 並局部復原?
更強的模型能提高上限;完整的 harness 才能讓能力穩定落在可交付範圍。真正會累積的優勢,不只是哪個模型最聰明,而是哪個環境能讓它的聰明被可靠地使用。
當這些控制面已經存在,而瓶頸轉成一個人同時接手多個 session,可以再看 多 Agent 工作台如何安排注意力、隔離與權限;介面負責看見工作,harness 仍負責讓工作可驗收。
訓練任務的具體驗收可接著看 CIFAR-10 執行收據案例:把 checkpoint、評估程式與人工介入綁在同一次執行,並保留尚未對帳的成本缺項。