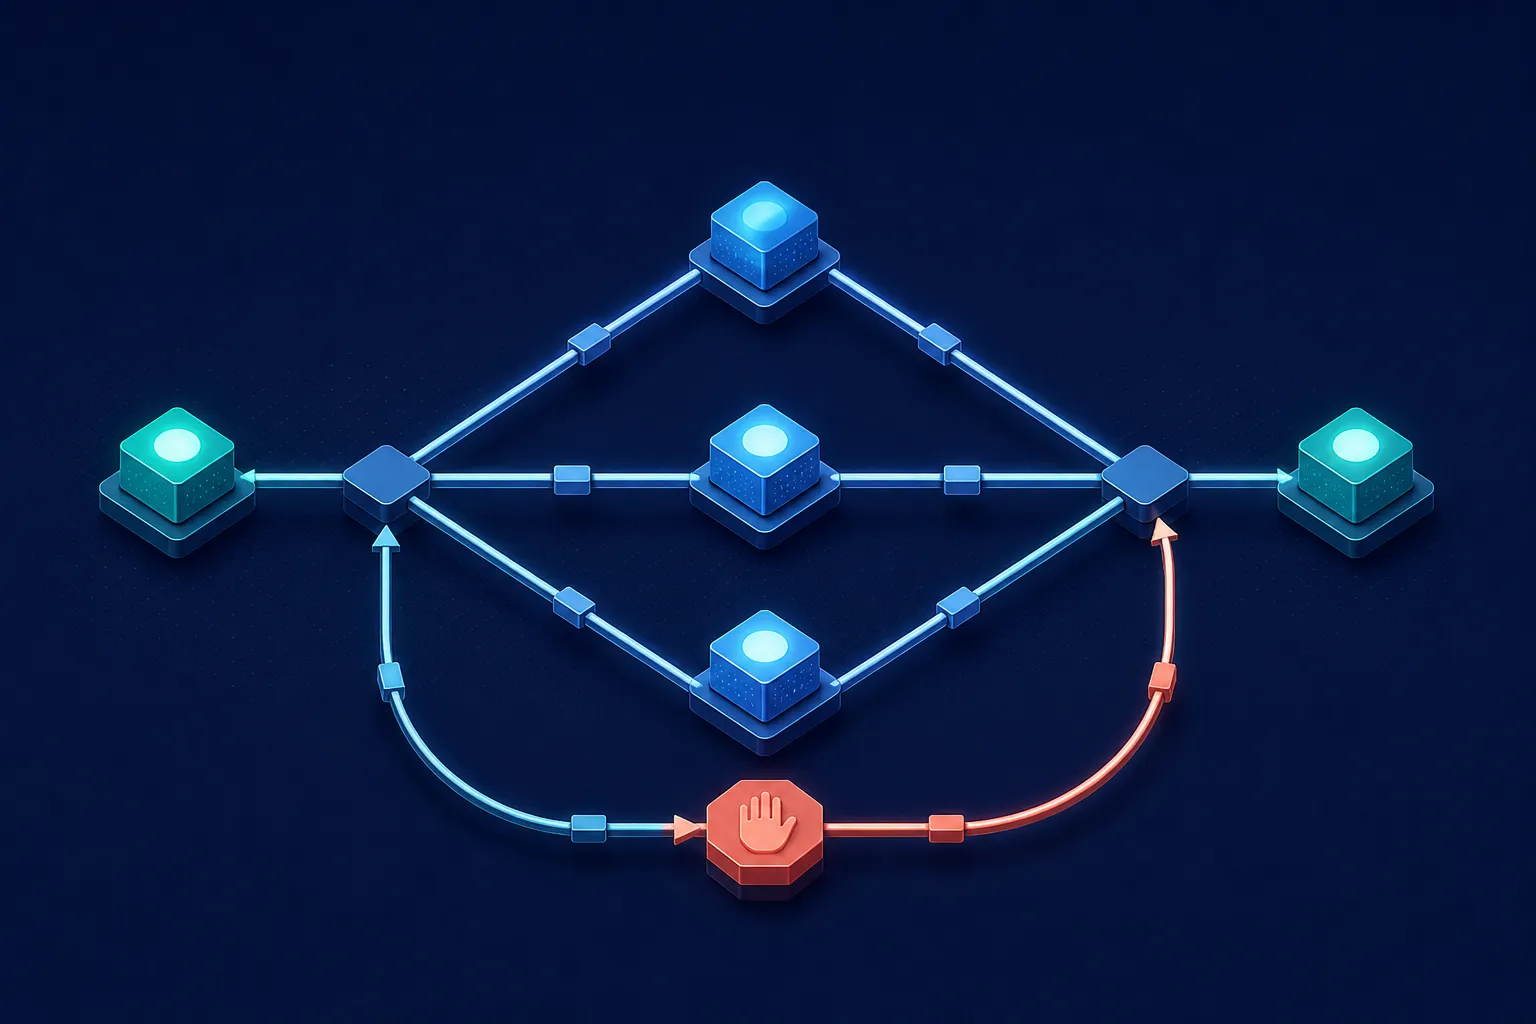
在構建 AI 應用時,最直覺的起手式是「線性鏈條(Linear Chain)」:將 Prompt A 的輸出丟給 Prompt B,再將 Prompt B 的輸出整理為最終答案。
這種線性思維在處理單純的文本摘要或格式轉換時運作良好。但當任務升級為「全端功能開發」、「多來源架構評估」或「複雜業務邏輯重構」時,線性鏈條的缺陷便暴露無遺:
- 單點崩潰:中間只要有一個環節產生幻覺,錯誤就會在下游被持續放大;
- 無法平行化:明明互不相依的子任務,卻必須被迫循序等待,延遲大幅拉長;
- 缺乏回饋機制:驗收失敗時無法精準回退到特定節點重試,只能推倒重來。
@anatolikopadze 提出的「Graph Engineering」,提供了處理這類多維度協同問題的架構視角。當任務確實具有平行、分支或局部重試需求時,將 Agent 工作流建模為「圖(Graph)」會是合適的選項。
Lunar 的後續長文把這個焦點說得更精確:多 Agent 最難的層次不是再調好一個節點的 prompt,而是決定工作能否並行、每條邊交接什麼資料、哪裡匯聚、哪裡拒絕,以及哪些狀態根本不該在人工核准前跨越。原始 X 討論 這是作者的架構提案,不是「圖一定更快、更便宜或更可靠」的普遍證明。
什麼是 Graph Engineering?
原文把 Graph 說得很樸素:它是一張畫出「哪些工作要做」與「哪些工作必須等待前一步結果」的工作計畫。節點是有明確輸入與輸出的單一工作;邊則只在有真實資料需要交接時才存在。本文再把這個概念對應到有向圖與狀態轉移的工程實作。
在圖工程中:
- 節點(Nodes):代表特定責任的 Agent、工具執行或確定性演算法;
- 邊緣(Edges):代表資料流、狀態轉移條件與控制信號;
- 狀態(State):跨節點共享並被嚴格管控的資料上下文。
菱形圖工程拓撲 (Diamond Pattern)
從任務拆解、正交平行實作到匯聚審查的標準圖架構
- 01Planner Node
任務規劃
分析目標並將大任務拆解為正交、互不干擾的獨立子任務規格。
Gate子任務相依性解耦檢查 - 02Parallel Fan-out
正交平行展開
多個特化 Subagent(如 UI、API、Test)在獨立沙盒中同步並行開發。
Gate隔離寫入避免資源互踩 - 03Fan-in Gate
狀態匯聚整合
將各平行節點產物匯聚,進行衝突檢測、型別對齊與跨模組組合。
Gate靜態分析與相容性檢查 - 04Review & Evals
獨立審查閘門
由獨立 Reviewer 進行安全與效能評估;未達標準則觸發受控回退迴圈。
Gate受控重試上限 (Max Retries)
先做 fake-edge test
原文最實用的檢查是逐一問每條箭頭:「下一步真的需要前一步的結果嗎?」若不需要,這條邊就是假相依,兩個工作應平行執行。常見的菱形流程則是 fan-out → 用一般程式碼 reduce → 由最終 Agent synthesize;把 reduce 留給確定性程式,而非再交給模型,可減少不必要的上下文與推理成本。
三種核心圖拓撲
- 平行展開與匯聚(Fan-out / Fan-in,菱形模式):
- 規劃節點將大任務切分為正交、互不依賴的子任務。
- 多個特化 Subagent 同時並行處理(例如:同時撰寫文件、後端代碼與前端串接)。
- 在匯聚節點透過衝突檢測與整合演算法完成合併。
- 條件分支路由(Conditional Routing):
- 根據前置節點的評估結果(例如程式碼修改的影響範圍或安全等級),動態導向不同複雜度的處理子圖。
- 受控回饋迴圈(Bounded Cyclic Loops):
- 允許工作流在「實作 → 測試 → 失敗 → 修復」之間循環,但必須具備最大重試次數、超時與人工介入的跳出條件(Escalation Path)。
讓邊傳遞資料,讓節點只負責一件事
一張圖不能只畫出「A 完成後換 B」。那是狀態通知,不是資料相依。每條邊最好都能用一句話說明交換物,例如:「reviewer 收到 claim、來源 URL、證據片段與信心等級」,而不是「reviewer 知道研究完成」。
這會迫使工作流把跨節點狀態做成可檢查的物件:
type ResearchFinding = {
  claim: string;
  sourceUrl: string;
  evidence: string;
  confidence: "low" | "medium" | "high";
  collectedAt: string;
};
結構化 state 讓下游節點能替換、重跑與稽核,而不用重新閱讀一大段對話。OpenAI 的 agent orchestration 文件也將 structured outputs、鏈式轉換、evaluator loop 與獨立任務的 parallel execution 列為可組合的控制面;這支持介面要明確,並不保證某個模型在節點內的判斷正確。OpenAI Agents:Multi-agent orchestration
平行不是免費的:先訂依賴與寬度預算
只有在兩項工作不讀取彼此產物時,才應把它們平行化。研究價格、評論與產品文件可以同時跑,最後再交給市場摘要;實作與測試若共用尚未穩定的檔案,則仍需要明確交接或隔離工作區。
新增 worker 前,同時問兩個問題:它是否增加了新的獨立覆蓋面?匯聚它的結果是否比它帶來的資訊更昂貴?這就是 width budget:限制同一輪可展開的 worker 數量、成本與等待時間。Anthropic 的多 agent 研究系統顯示,orchestrator-worker 架構適合平行探索與綜合,但也指出其內部評估的 token 使用量約為單一 chat 的 15 倍,且在 worker 高度共享 context 或相依很多時並不適合。Anthropic:How we built our multi-agent research system
因此,優化目標不是 agent 數量,而是「每一個並行分支帶來多少不重複、可用的證據」。這也把注意力轉到 critical path:端到端延遲由最長的必要相依鏈決定,不由流程圖上的方塊總數決定。
匯聚前先用程式縮減,驗證要與產生分工
fan-in 最常見的失敗是把所有 worker 的原始長文塞給最後一個模型。它於是同時要去重、排序、補欄位、找矛盾與寫結論,變成昂貴又難除錯的垃圾收集器。
先把不需要判斷的事交給一般程式:依 ID 去重、排序、驗證 schema、分組、過濾缺欄位與計數;再讓模型處理真正含糊的取捨與綜合。這是 reducer 的邊界,不是另一個「萬用 agent」。
驗證也應有不同目標:worker 尋找最好的可行答案,verifier 則尋找拒絕它的理由、來源衝突、過期資料或測試反例。若 verifier 永遠不能阻擋結果,它只是裝飾。對研究可要求來源與日期;對程式則用測試、靜態分析與獨立 review 作為圖之外的 anchors。
核准不是節點,而是不能繞過的邊
「提醒 agent 發布前先問」不是 human-in-the-loop。真正的設計是把 publish、付款、刪除、權限變更等節點做成在 approval 記錄存在前不可達;核准是 state 跨越邊界的條件,而不是聊天中的禮貌規則。
OpenAI 的 guardrail 文件區分 agent-level 與 tool-level guardrails,並明確提醒 parallel guardrails 可能在拒絕前就允許模型或工具造成 side effect。這正是高風險操作不能只靠 prompt 的理由。OpenAI Agents:Guardrails NIST 也建議將 oversight 責任、授權、audit history、override 與 go/no-go 決策留下紀錄;它沒有指定你必須採用哪一種圖拓撲。NIST AI RMF Playbook
每個會失敗的節點還要有可見的 policy:重試幾次、何時換工具或模型、哪些失敗可降級繼續、哪些必須阻擋整個 run。不要把少一個 worker 的輸出偽裝成完整結果;讓最終 state 帶上缺失與重試紀錄。
用圖的指標改善圖,不要只回看聊天紀錄
開始觀測後,不必先做複雜 dashboard。先量五個值就足以定位下一個瓶頸:
- critical-path latency:真正不可避免的等待在哪裡;
- node failure 與 retry rate:哪個工具、schema 或 prompt 最脆弱;
- fan-out efficiency:多少平行輸出帶來不重複的可用資訊;
- verifier kill rate:驗證是否真的形成選擇壓力;
- human intervention rate:人仍在手動補救哪一個邊界。
這些指標不是品質本身,但能避免用 token、session 或開了多少 agent 代替系統健康度。當任務很小、每一步確實相依、需要一個連貫觀點,或協調成本大於工作本身時,單一 agent 仍是更好的架構。
何時使用 Graph Engineering?
不是所有系統都需要圖結構。以下是值得引入 Graph Engineering 的典型訊號:
| 場景特徵 | 線性模式(Linear) | 圖工程(Graph Engineering) |
|---|---|---|
| 任務相依性 | 步驟具高度先後因果關係 | 存在大量可平行的正交子任務 |
| 驗收機制 | 最終產物單次檢查 | 多個特化 Reviewer(安全、效能、型別)分別把關 |
| 錯誤修復 | 全局重跑 | 局部節點定向重試與狀態回滾 |
| 成本與延遲 | 低 Token 開銷、低協調成本 | 較高 Token 與協調開銷,以複雜度換取平行處理與分段驗證 |
警惕過度工程:何時「不要」使用圖?
圖結構帶來靈活性的同時,也引入了可觀的系統複雜度:
- 狀態同步開銷(State Overhead):多節點並行讀寫容易導致狀態覆蓋與 Context 膨脹。
- 除錯難度上升:非線性執行路徑讓追蹤問題變得困難,必須仰賴完整的 Trace 遙測。
- Token 與時間浪費:對於「修改單一變數名稱」或「修復拼寫錯誤」等微小任務,啟動多 Agent 圖工作流如同用大砲打蚊子。
工程準則:從最簡單的單一迴圈(Loop)或線性流程開始。唯有在出現明確的「平行加速需求」、「多維度獨立審查」或「複雜分支條件」時,才升級為 Graph Engineering。
圖的拓撲也不等於事實正確。原文稱之為 anchors:實際通過的測試、已入帳的資料或其他不可由 Agent 自行辯解的外部證據。沒有這些錨點,再多互相審查的節點也可能只是在一致地犯錯。