在單體架構(Monolithic Architecture)時代,當線上系統發生異常時,工程師最熟悉的排障方式是:登入單一伺服器,使用 tail -f /var/log/app.log 或 grep "NullPointerException" 來搜尋錯誤軌跡。
然而,當系統演進為包含數百個微服務、數千個 Kubernetes Pod 與分散式節點的現代雲原生架構時,「日誌分散在各處、生命週期短暫(容器重啟即銷毀)」 使得傳統排障方式徹底失效。
由 Elasticsearch、Logstash、Kibana 組成的 ELK Stack(以及加入 Beats 的 Elastic Stack),正是為了解決海量分散式日誌的「集中採集、結構化解析、毫秒級全文檢索與視覺化分析」而誕生的黃金標準。
本文基於 ByteByteGo ELK Stack 指南、Elastic 官方文件與大規模生產實踐,深度拆解 ELK 的內部運作機制與現代可觀測性架構演進。
邊緣採集與削峰 (Filebeat + Kafka)
Filebeat 輕量採集日誌,Kafka 削峰避免流量打滿,Logstash / Vector 進行 Grok 結構化解析。
倒排索引 (FST) 與 Doc Values
Lucene 倒排索引實現毫秒級全文檢索,Doc Values 列存加速彙總統計,分片保證水平擴展。
即時探勘與動態告警
Discover 依據 TraceID 精準定位問題,視覺化 Dashboard 監控系統健康度與 5xx 錯誤率。
成本優化與開源替代
Grafana Loki 僅索引標籤將日誌壓縮直寫 S3(成本降 80%),OpenSearch 提供無版權風險的開源選擇。
一、分散式日誌管理的四大核心挑戰
在建構企業級日誌系統前,必須解決以下四大核心工程挑戰:
- 資料分散與易失性(Ephemeral Pods):容器被銷毀重建後,本地日誌立即遺失,必須在毫秒內將日誌搬離邊緣節點。
- 格式不一與非結構化(Heterogeneous Formats):Nginx 訪問日誌、Java 堆疊異常(Stack Trace 多行日誌)、JSON 結構化日誌混雜在一起,難以統一過濾。
- 流量尖峰與寫入衝擊(Write Spikes):線上促銷或服務雪崩時,每秒可能產生數十萬條錯誤日誌,若直連儲存庫會瞬間打垮資料庫。
- 檢索效能與成本平衡(Search Speed vs. Storage Cost):既要支援數十億條日誌的秒級關鍵字定位,又不能讓磁碟儲存費用無限膨脹。
二、ELK Stack 端到端資料流與核心組件
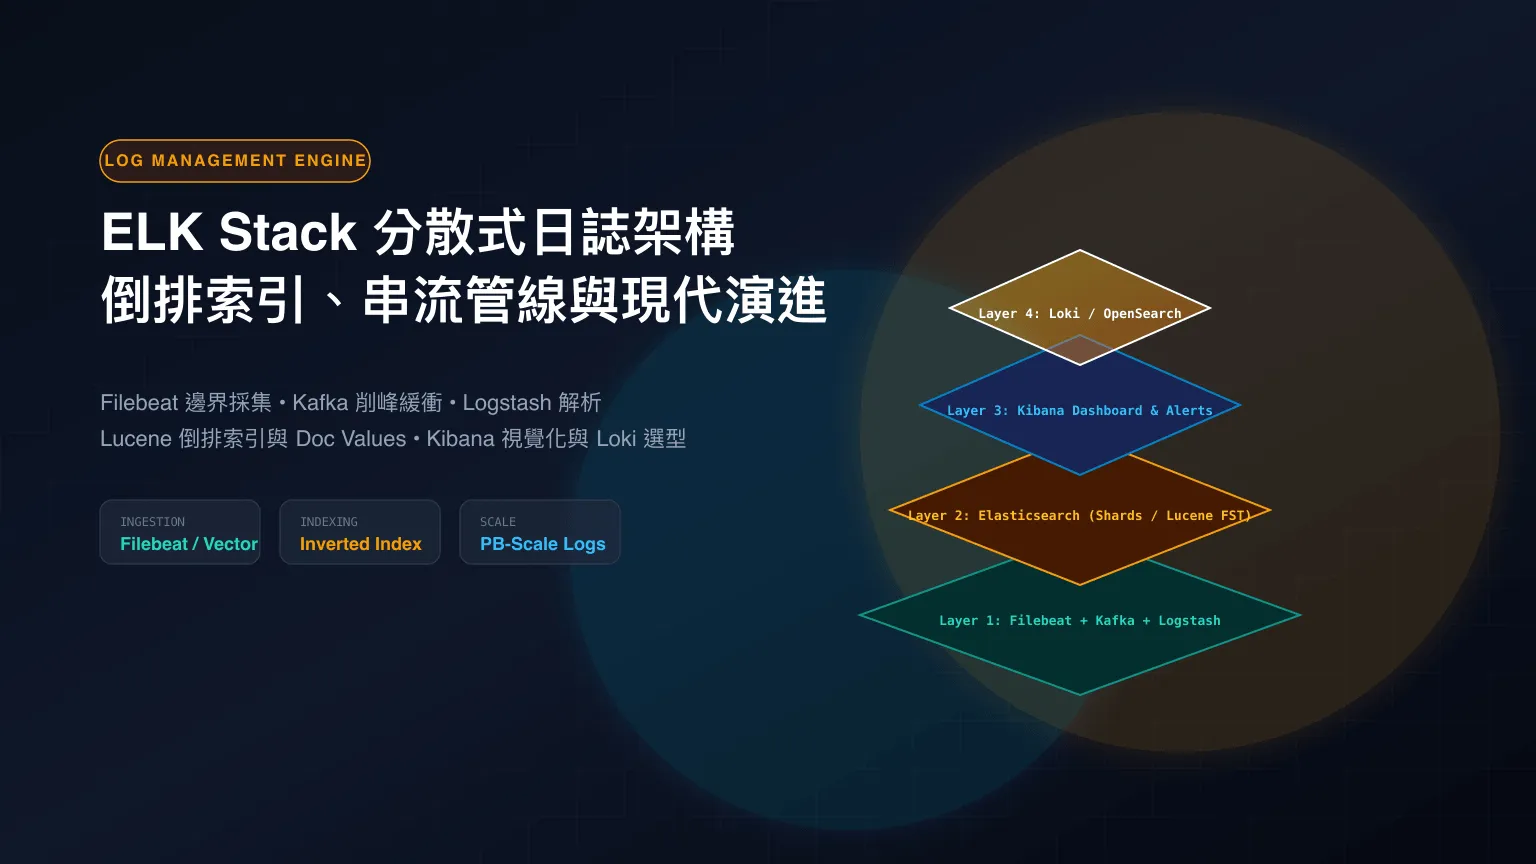
標準的現代 Elastic Stack 管線採用四層分工架構:
三、各核心組件深入拆解
1. Filebeat:邊緣日誌搬運工
早期直接在每個節點部署 Logstash,但由於 Logstash 運行在 JVM 上,記憶體消耗動輒數百 MB,對業務容器造成嚴重資源爭搶。
Filebeat 採用 Go 語言重寫:
- 極低資源消耗:CPU 佔用率
< 1%,記憶體通常小於 30 MB。 - 背壓控制(Backpressure Sensitive):當下游 Kafka 或 Logstash 繁忙時,Filebeat 自動放慢讀取檔案的速度,防止下游過載崩潰。
- 記錄讀取位移(Registry File):記錄每個檔案讀取的 Inode 與 Offset,即使重啟也能保證 At-Least-Once(至少一次) 傳輸。
2. Kafka 緩衝層:防禦寫入雪崩的護城河
在大型生產環境中,絕不能讓 Filebeat 直接寫入 Elasticsearch。
當業務爆發異常產生百萬 QPS 錯誤日誌時,Elasticsearch 的 Bulk 寫入執行緒池會迅速耗盡並拋出 429 Too Many Requests (EsRejectedExecutionException)。
引入 Apache Kafka 作為緩衝池:
- 將寫入壓力完全解耦;
- Logstash 可以根據 Elasticsearch 的實際處理能力,平穩地從 Kafka 消費拉取日誌。
3. Logstash:強大的資料清洗與結構化管線
Logstash 採用 Input ➔ Filter ➔ Output 三階段管線:
# Logstash 典型過濾配置範例
filter {
  # 1. 解析 Nginx 訪問日誌
  grok {
    match => { "message" => "%{IPORHOST:client_ip} - %{USER:ident} [%{HTTPDATE:timestamp}] "%{WORD:method} %{URIPATHPARAM:request} HTTP/%{NUMBER:http_version}" %{NUMBER:status_code} %{NUMBER:bytes}" }
  }
  # 2. IP 地理位置富化
  geoip {
    source => "client_ip"
  }
  # 3. 敏感資訊脫敏 (如手機號碼/信用卡號)
  mutate {
    gsub => [ "message", "(\d{3})\d{4}(\d{4})", "\1****\2" ]
  }
}
四、Elasticsearch 核心底層:為何檢索速度如此極致?
Elasticsearch 基於 Apache Lucene 構建,其極致的查詢與聚合效能來自兩大底層結構:
1. 倒排索引(Inverted Index)與 FST 詞典
傳統關聯式資料庫(B+ Tree)搜尋文本時需要全表掃描 LIKE '%error%'。而 Lucene 會在寫入時進行分詞(Tokenization),建立「詞彙(Term)到文檔 ID(Posting List)」的映射:
- FST(Finite State Transducer):為了快速在數百萬個詞彙中定位,Lucene 將 Term Dictionary 壓縮為記憶體中的有限狀態轉換機,佔用極少記憶體即可實現前綴快速尋址。
- Roaring Bitmap:對 Posting List 進行高效率位元遮罩運算,多條件查詢(如
"NullPointer" AND "Timeout")只需做極快的位元交集(Bitwise AND)。
2. Doc Values:列式儲存(Columnar Storage)
倒排索引擅長搜尋(Search),但極不擅長排序(Sort)與統計聚合(Aggregation)。
Elasticsearch 引入了 Doc Values:在磁碟上維護一份與文檔順序對應的列式儲存矩陣,透過 OS Page Cache 將數值型字段(如 status_code, response_time)常駐記憶體,讓 Kibana 能夠在毫秒內計算出 P99 延遲與 5xx 錯誤分佈。
五、ELK 的痛點與現代日誌架構演進
雖然 ELK 功能強大,但在 PB 級日誌規模下也暴露出了顯著短板:
| 架構痛點 | 傳統 ELK 的局限 | 現代演進方案 |
|---|---|---|
| 資源消耗巨大 | Logstash 佔用高額 JVM 顯存與 CPU | 改用 Vector (Rust) 或 Fluent Bit (C) |
| 儲存成本昂貴 | ES 為全文字段建立倒排索引,儲存膨脹 1.5x~2x | 改用 Grafana Loki(僅索引標籤,壓縮直寫 S3) |
| 開源授權變更 | Elastic 於 2021 年轉為 SSPL 雙授權 | AWS 發起 OpenSearch(純 Apache 2.0 開源分支) |
關鍵選型建議:何時用 ELK?何時用 Loki?
- 選擇 ELK / OpenSearch 的場景:
- 需要精確的全文關鍵字檢索(例如在未結構化的日誌文字中搜尋特定 TraceID 或錯誤堆疊);
- 需要複雜的多維度日誌關聯分析與商業智慧看板。
- 選擇 Grafana Loki 的場景:
- 預算有限、日誌吞吐量極大(數十 TB/天);
- 已經普及 OpenTelemetry,通常藉由 TraceID 關聯或 Prometheus 指標精確縮小 Pod / Label 範圍,對無索引日誌進行即時流式過濾(LogQL)。
六、工程落地最佳實踐
- 實施日誌生命週期管理(Index Lifecycle Management, ILM):
- Hot 節點(SSD):存放 3 天內的熱日誌,支撐高併發寫入與即時排障;
- Warm / Cold 節點(HDD / 物件儲存):存放 3~30 天日誌,執行 Read-Only 與 Force Merge 壓縮 Segment;
- Delete 階段:自動刪除超過 30 天的歷史索引,防止磁碟爆滿。
- 在業務層結構化(JSON Logging):
- 應用程式應直接輸出 JSON 格式日誌(包含
trace_id,service,level,duration_ms),大幅減輕 Logstash Grok 正則解析的 CPU 開銷。
- 應用程式應直接輸出 JSON 格式日誌(包含
- 禁用無意義字段的 Indexing:
- 對於超長日誌文字且不需要模糊搜尋的字段,在 Mapping 中設定
"index": false,大幅節省 40% 以上的磁碟空間。
- 對於超長日誌文字且不需要模糊搜尋的字段,在 Mapping 中設定