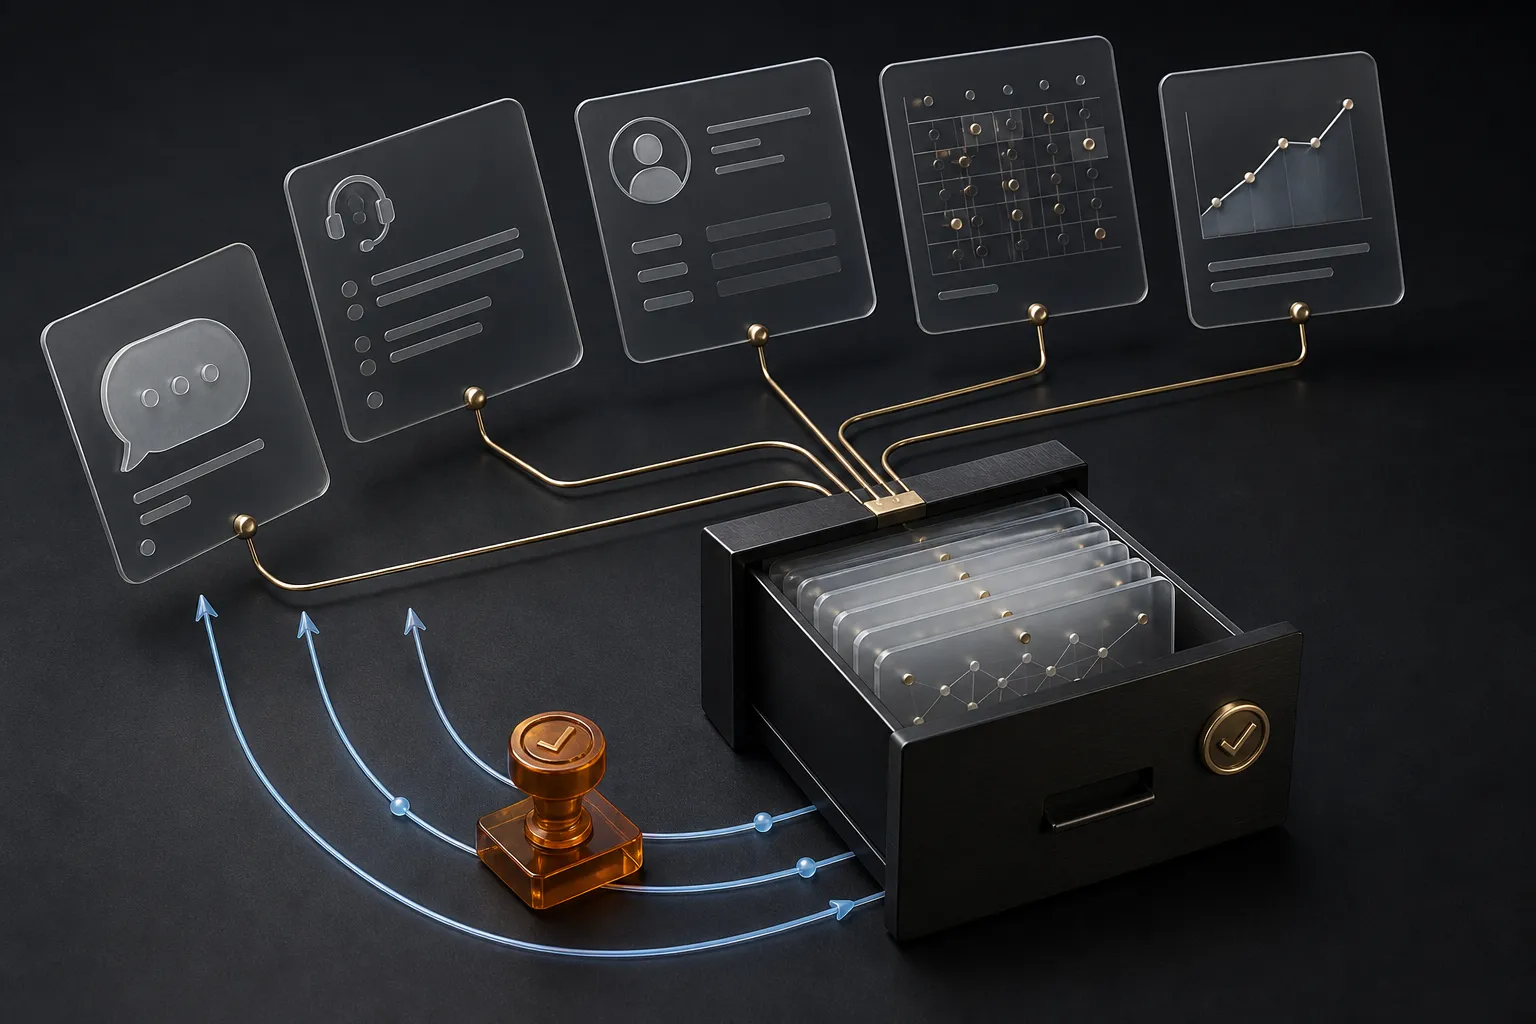
行銷團隊常已經有 CRM、銷售通話、客服工單、內容數據與廣告報表,但它們各自回答不同問題。下一次要寫一封外寄信、調整一頁 landing page,或挑選一個實驗時,團隊仍要重新拼湊「客戶最近到底在意什麼」。
The Startup Ideas Podcast 提出的 Marketing Engineer,不是一個已被定義好的職稱,而是一種工作模型:用資料、程式碼、agent 與判斷,把市場訊號轉成下一個可量測的 pipeline 行動。其核心提案是建立一個保存客戶事實與行銷實驗的 Growth OS/growth repo。原始 X 討論
這個方向值得試,但不該把它誤解成「把所有行銷資料丟給 agent」。薪資、成效與工具組合的預測沒有足夠公開證據可當作事實。更有用的問題是:能否先讓一個小流程,從可追溯的客戶證據走到一個可審核的實驗,再把結果寫回去?
Growth Repo 的目的,是讓下一個決定有來處
repo 不必一開始就是複雜的資料平台。它是把原本散落在人的記憶和 SaaS 工具中的「可用上下文」,整理成團隊可檢查、可更新的工作記憶。若需要保留版本和變更脈絡,Git repository 天生提供工作樹、物件與 refs 的結構;但不需要為了這個概念硬把每份資料都搬進 Git。Git repository layout
第一版只要有五份能真的被使用的檔案:
growth/
├── customer-truth.md     # 引文、來源連結、日期、受影響的客群
├── positioning.md        # 已驗證與待驗證的訊息,不是 slogan 清單
├── experiments.md        # 假設、版本、owner、指標與判定日期
├── agent-jobs.md         # 每個 agent 的讀取範圍、產出與禁止事項
└── weekly-review.md      # 本週結果、反例、下一個決定與連結
重點不是資料夾數量,而是 customer-truth.md 裡每一條可用訊號都能回到來源:例如某次訪談、工單、成交失敗原因或已核准的分析。沒有來源的「市場洞察」可以保留為假設,但不能被 agent 當成客戶事實。
先選一條決策鏈,不要先做六個 agent
「讓 agent 寫十篇貼文」通常是一個輸出要求,不是一條學習鏈。更小也更可驗證的切片是:根據本週新進的銷售異議,提出一個已核准的 landing page 訊息測試。
input:
  sources: 本週銷售通話摘要與客服工單
  required_evidence: 每個主張都附來源連結與日期
decision:
  hypothesis: "是否應把『報價後無人跟進』放入頁面主標?"
  human_gate: 行銷 owner 核准訊息與發布範圍
output:
  artifact: 一個頁面文案版本與測試計畫
  success_metric: 目標客群的合格 demo 申請率
review:
  date: 兩週後
  write_back: experiments.md 與 positioning.md
這個契約把 agent 限在資料整理、草稿與比對;是否發布、對誰發布、怎麼定義合格 demo,仍是 owner 的決定。它也避免用「寄出數」或「生成篇數」替代業務訊號。
agent job spec 要像職務說明,不像魔法咒語
把 agent spec 寫成職務說明,是一個實用的最低標準。與其給一段越來越長的 prompt,不如把四個邊界固定下來:
| 邊界 | 最小問題 |
|---|---|
| 資料 | 它能讀哪些檔案與哪些欄位?來源缺失時是否停止? |
| 工作 | 它要產出摘要、候選假設還是可發布內容? |
| 權限 | 哪些動作只可草擬,哪些一定要 owner 核准? |
| 評估 | 哪個結果證明假設值得保留,何時回顧? |
coding agent 的確可以讀取 codebase、修改檔案與執行命令;但這是能力描述,不代表它應自行發信、改價或發布內容。Claude Code overview OpenAI Codex 對有外部副作用的流程,核准、權限與紀錄必須在模型之外強制執行。
這也與長時間 agent 的工程經驗一致:工作進度、狀態與驗證要留在 session 以外,否則下一次執行只會重新猜測之前發生的事。Anthropic:Effective harnesses for long-running agents 在 Codex 的脈絡裡,sandbox 與 approval policy 也是模型外的控制面,而非一句 prompt 可以取代的安全保證。OpenAI:Running Codex safely
每次回寫,都要能推翻自己
Growth Repo 最容易退化成另一個漂亮的文件庫。避免這件事的方法不是增加更多自動化,而是讓每一次回寫都回答三個問題:
- 這個結論依據哪一些原始訊號?
- 這次實驗的版本、受眾與成功判定是什麼?
- 若數字沒有改善,哪一條假設要降級或刪除?
例如「客戶想要即時回覆」不該直接寫入 positioning。若證據只來自兩個客服工單,應保留它的樣本與日期,並把它列為下一輪待測訊息。若 landing page 測試沒有帶來更多合格申請,回寫的結果應該是「此訊息在這個受眾與版本下不成立」,而不是用新的措辭掩蓋失敗。
這使 repo 成為決策紀錄,而不只是 agent 的 context window。agent 可以依它更快地草擬、比較與整理,但真正累積的是團隊願意被證據修正的判斷。
從一個 lane 開始,才知道要不要擴大
第一個月不需要競品監看、內容工廠、外寄自動化與成長 dashboard 全部上線。選一條已有原始資料、可由單一 owner 核准、兩週內能看到結果的 lane;先讓它完整走過「來源 → 假設 → 人工 gate → 實驗 → 回寫」。
若這條鏈已能持續產生可用的決定,再增加第二個資料來源或第二個 agent。若做不到,問題通常不是少了一個模型,而是來源不可追溯、指標無法判定,或沒有人對結果負責。這與 AI Business Partner 不是新職稱:把 AI 導入變成有人負責的業務迴路 的界線相同:角色名稱可以變,但 owner、例外與驗證不能消失。