AI Agent 工程化與工作流實戰
本系列依難度與架構脈絡由淺入深編排,建議依章節序號循序閱讀。
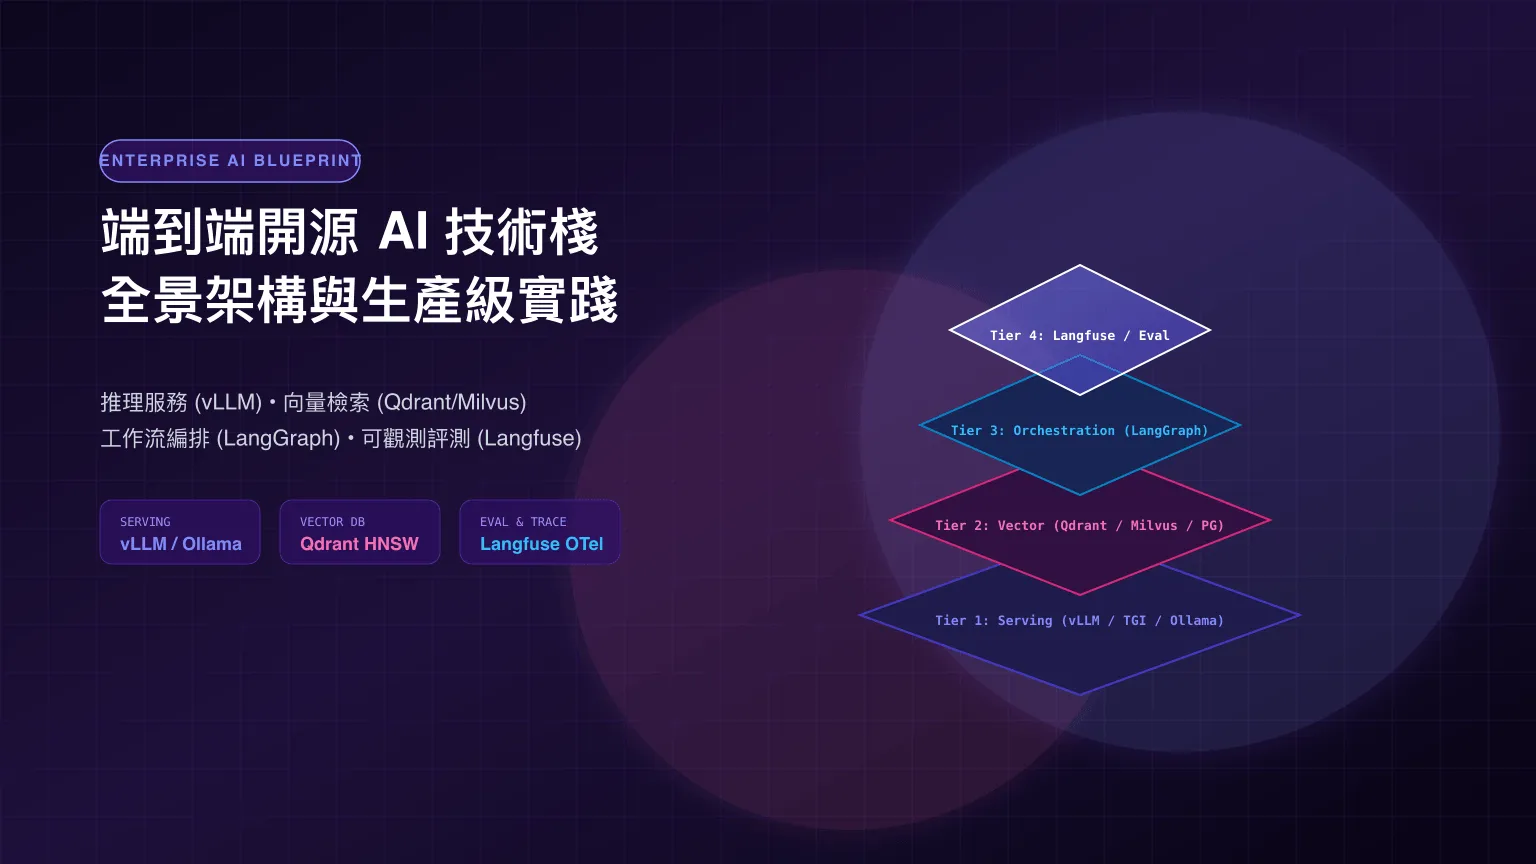
企業級開源 AI 技術棧藍圖:從 vLLM 推理、Qdrant 向量檢索到 LangGraph 編排與 Langfuse 評測
系統性梳理企業私有化落地的大模型開源技術棧(Open Source AI Stack):剖析模型服務層(vLLM/Ollama 多 GPU 張量平行)、向量與記憶層(Qdrant/Milvus HNSW 混合檢索)、應用編排層(LangGraph 狀態圖/MCP 協議),以及可觀測與自動評測層(Langfuse OTel 鏈路追蹤與 RAG Triad 幻覺防禦)。
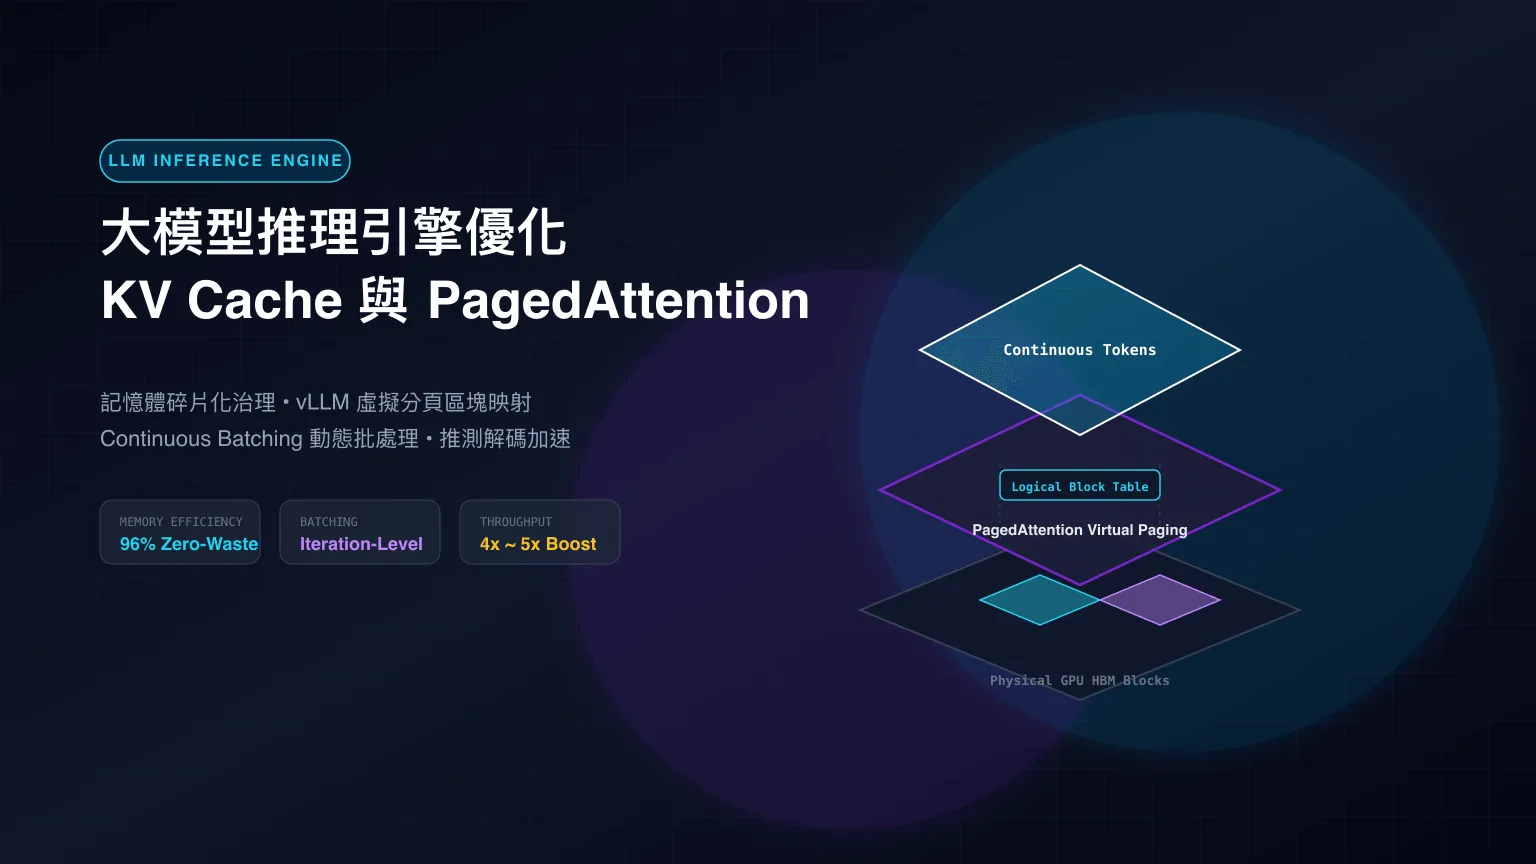
大模型推理引擎優化全景:KV Cache 記憶體碎片化、vLLM PagedAttention 與推測解碼實戰
深度拆解 LLM 大語言模型推理加速與顯存優化核心技術:剖析 Prefill 與 Decode 階段的計算與記憶體瓶頸;詳解 KV Cache 為何浪費 60%~80% 顯存;深入 vLLM PagedAttention 虛擬分頁區塊映射與零拷貝分叉;解析 Continuous Batching(持續批處理)與 Speculative Decoding(推測解碼)的吞吐翻倍實踐。
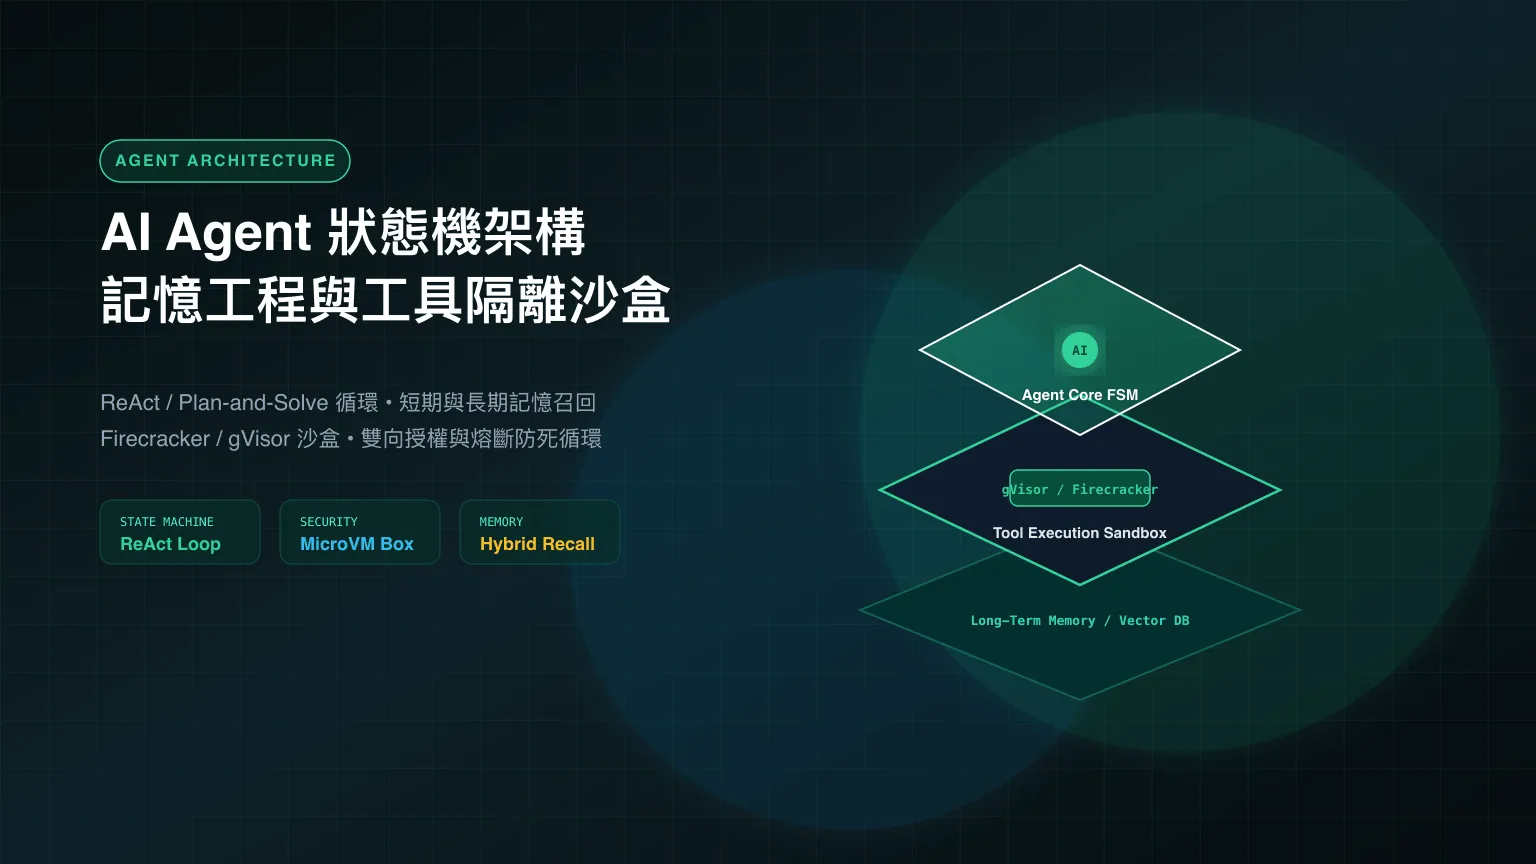
AI Agent 狀態機架構演進:ReAct 決策循環、記憶工程與 Firecracker 工具隔離沙盒
全面拆解生產級 AI Agent 系統架構:深入對比 Prompt 鏈、DAG 工作流與有限狀態機(FSM);剖析 ReAct(Thought-Action-Observation)循環、Plan-and-Solve 與反思機制;詳解短期工作記憶(滑動視窗/摘要)與長期向量情境記憶架構;剖析基於 Firecracker / gVisor 的 MicroVM 工具隔離沙盒與防死循環熔斷設計。
Trace Engineering:自主 AI Agent 的可觀測性與除錯架構
當 Agent 在背景執行多輪任務時,單靠一般 Log 不足以釐清決策脈絡。從因果追蹤、故障環境重播到驗證收據,拆解生產級 Agent 的 Trace Engineering 實踐。
AI Agent 需要的不是更長 Context,而是 Memory Engineering
從 Capture、Consolidate、Retrieve、Reconcile 到 Decay,拆解 AI Agent 如何建立可更新、可遺忘,也能被驗證的長期記憶。
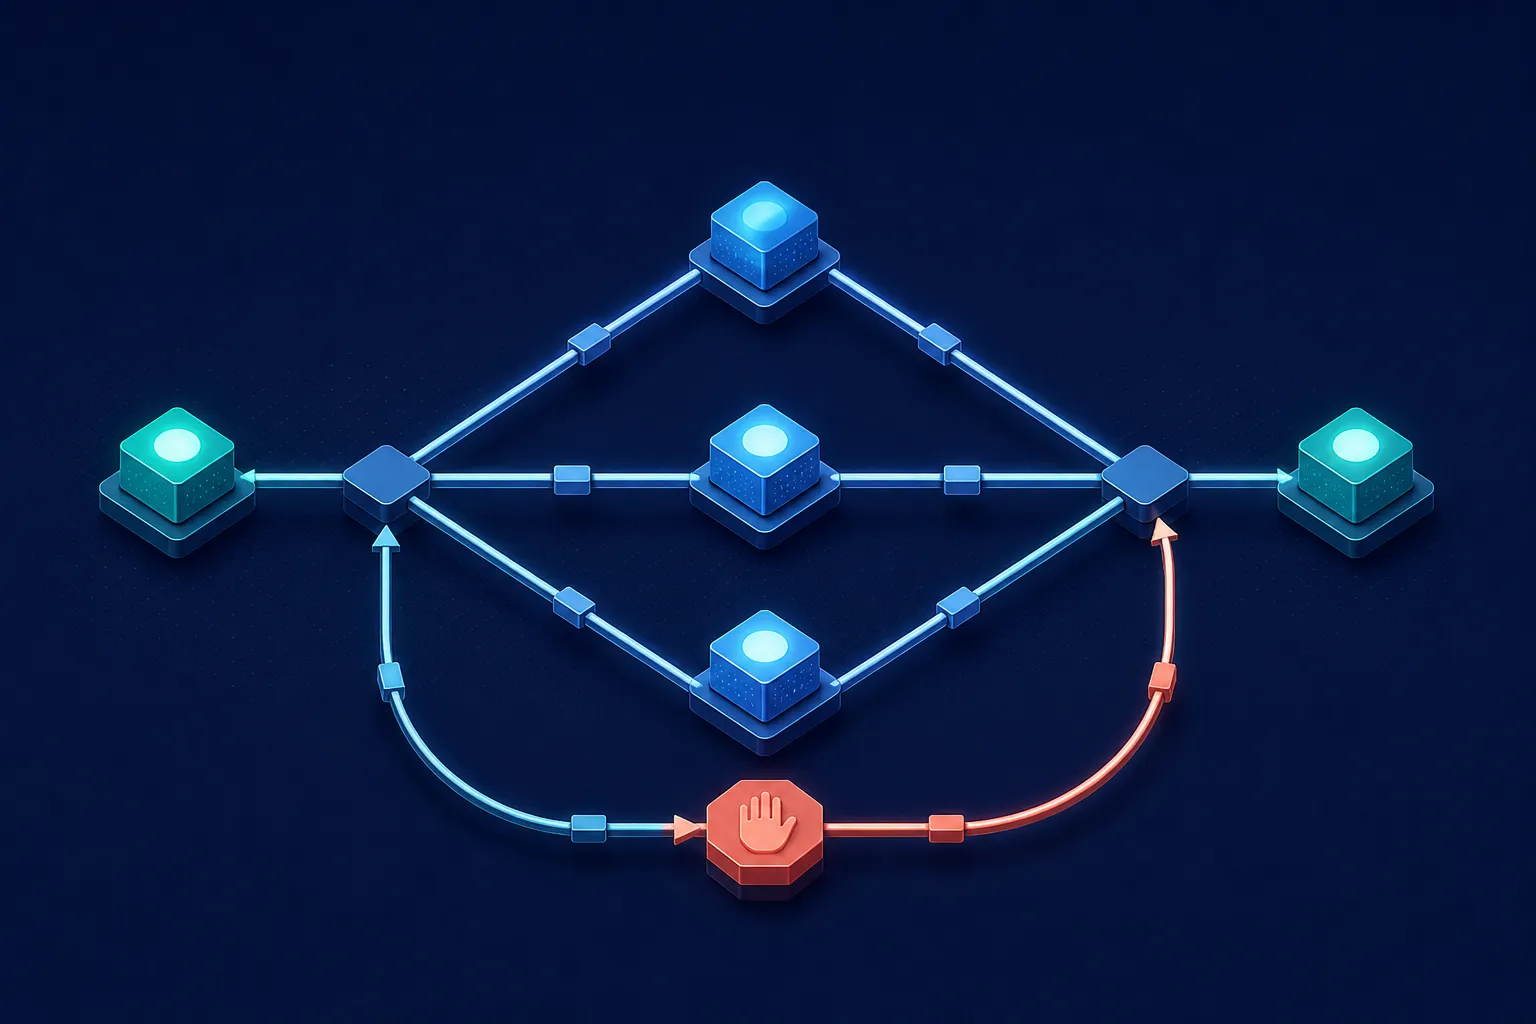
Graph Engineering:超越線性 Prompt 的 Agent 架構與適用邊界
真實工程任務很少是單向線性的。從菱形展開、平行審查到條件迴圈,拆解 Graph Engineering 的核心拓撲模式、適用情境與過度工程陷阱。
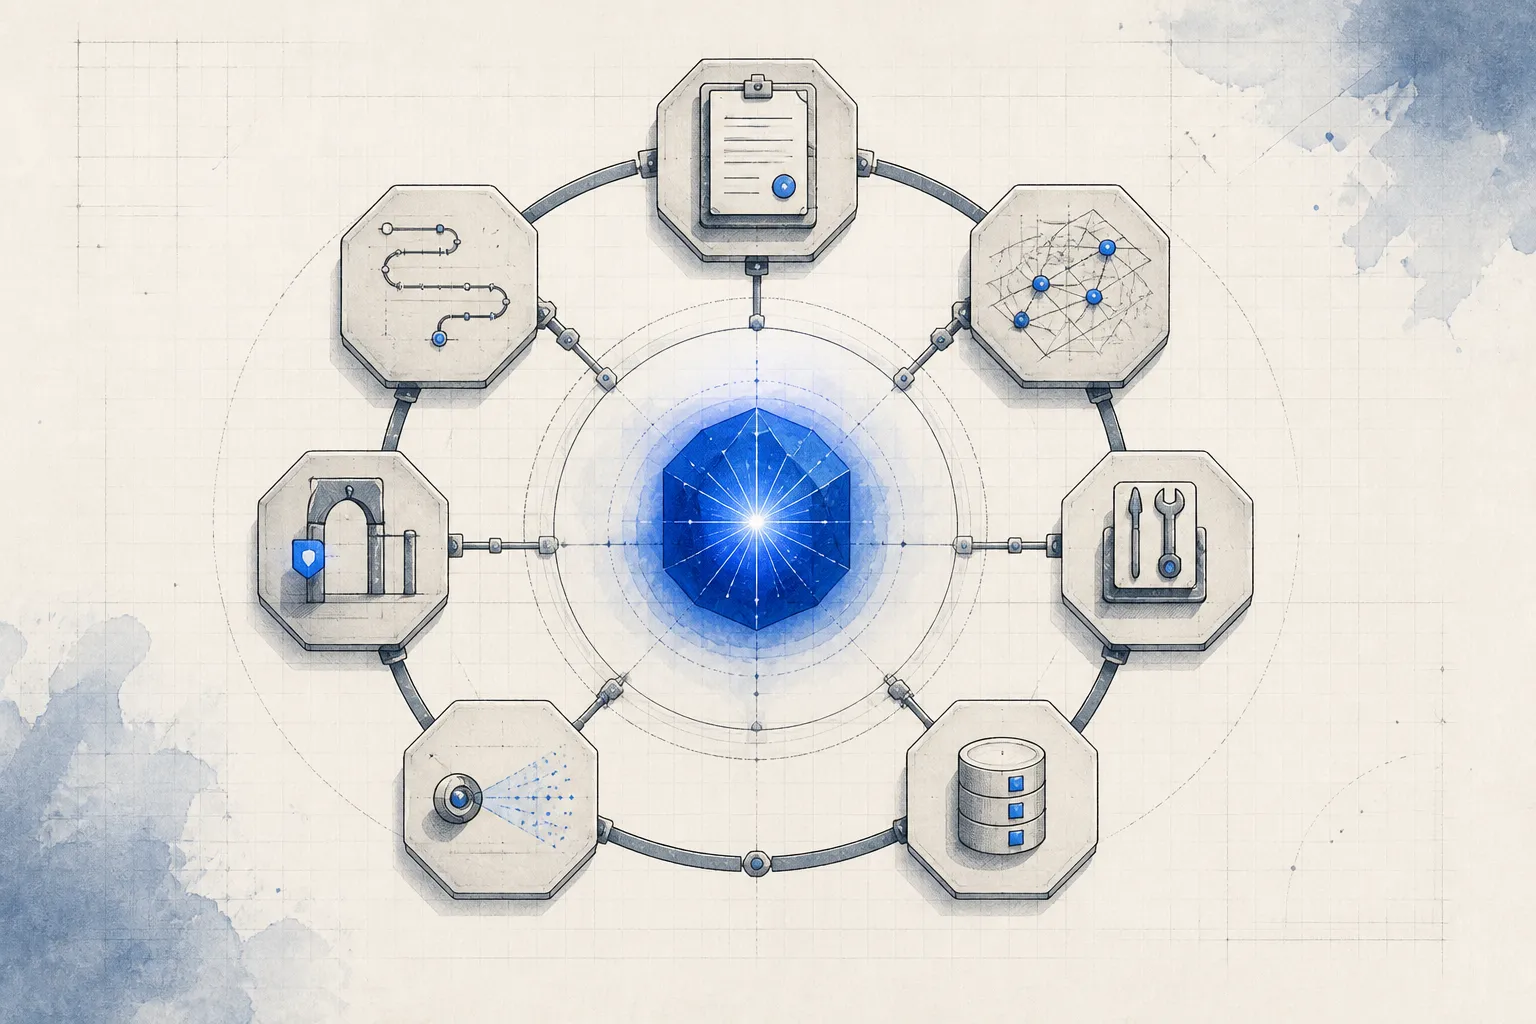
AI Agent 不可靠,先別急著換模型:Harness Engineering 的七個控制面
從多篇 Harness Engineering 實務出發,拆解任務契約、工具、持久狀態、驗證、權限與追蹤如何把模型能力變成可交付的系統。
多 Agent 工作台不是多開終端:先設計注意力、隔離與權限
從一套 2,000 小時的 Agentic Engineering 工作台出發,拆解多 Agent 操作真正需要的狀態、優先級、隔離、持久執行與模型外權限。
長任務不要從聊天紀錄續命:用驗收證據讓 Agent 接著交付
以 Microsoft Argus 與一個公開效能 PR 為例,拆解長時間 Agent 工作真正需要保存的狀態、獨立審查與停止規則;用最小任務契約判斷何時值得增加一層 runtime。
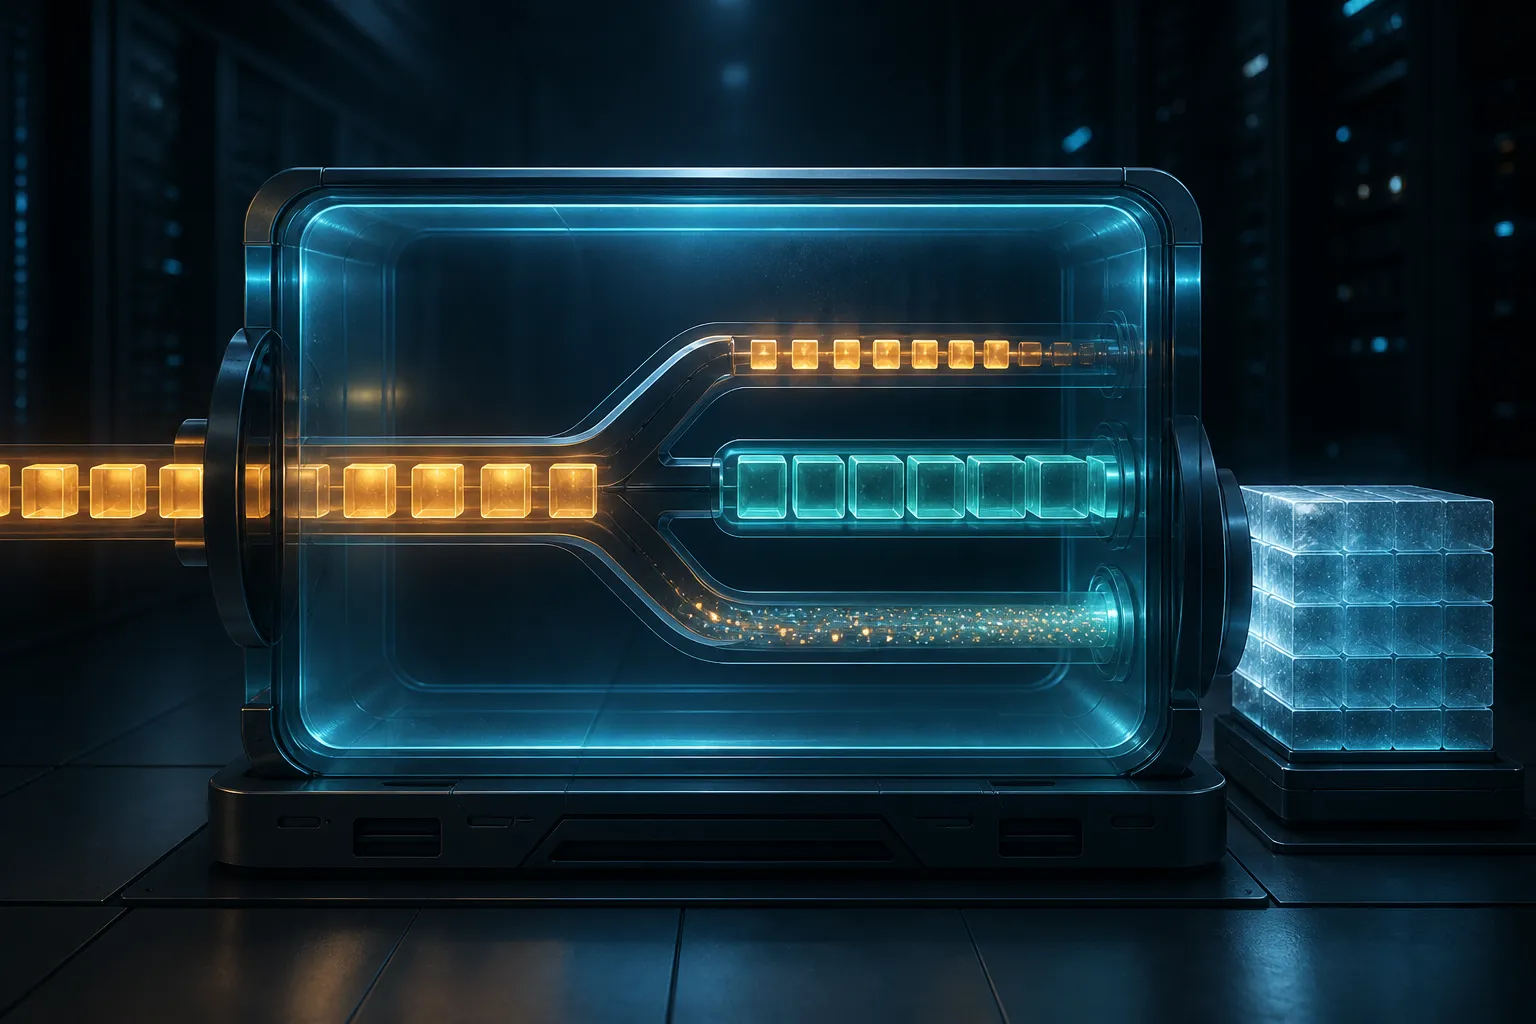
KV Cache 不是一個優化項:先分清楚你要減少的是容量、頻寬還是重複
從 Avi Chawla 的 KV cache 分類出發,將模型架構、token 保留、位元精度、配置重用與 offloading 變成一張 production capacity ledger,避免把不同代價誤當成同一個開關。
模型變強後,Harness 該先刪什麼:保留外部狀態與可驗收證據
把模型升級當成一次 Harness 消融測試:刪除只補模型弱點的固定流程,保留外部狀態、權限與獨立驗收,並用四組對照量出真正收益。
Attention 不是一條公式:用三個不變量看懂 LLM 的 Q、K、V 實作
從 Tech with Mak 的 Attention 手冊出發,用 tensor shape、mask direction 與 decode state 三個不變量檢查 Q/K/V、RoPE、KV cache 與 FlashAttention 的實作邊界,避免把數學、位置與 kernel 最佳化混成同一件事。
別先裝 19 個 Skill:把 Agent 能力當成有權限的工作契約
從一份 Hermes Skill 清單出發,建立 Agent 能力的最小採用門檻:明確痛點、最小權限、可觀察證據與移除規則。用這個門檻逐步加能力,避免把可用的 Agent 變成無法審計的工具抽屜。
Vibe Coding 上線前,別問「安全嗎」:交出七項可重跑的證據
把公開網站的安全驗收收斂成七項可重跑結果:帳號隔離、後端授權、併發計費、付款冪等、資源上限、憑證輪換與覆蓋缺口。它們不能取代安全審計,但能阻止「功能能跑」被誤當成可以上線。
AI 協作不會自己複利:把每次交付變成下一次可驗證的輸入
把 AI 協作中的需求邊界、長期規則、驗證結果與重複失敗分開保存,建立能減少重複說明、也不會把舊錯誤自動放大的最小回饋迴圈。
Claude 工作環境別一次裝滿:先把可重用的 context 與核准邊界排好
從 Claude 的 memory、projects、skills、connectors 到排程與瀏覽器操作,建立一條由低副作用到可驗收自動化的採用順序,避免把「少重複貼 context」誤當成「可以自動代表你行動」。
MCP 接得上不等於能放心執行:先把介面、授權與核准分開
用 MCP 連接資料與工具前,先分清 Prompts、Resources、Tools 的控制權,並以最小權限、可見輸入與可稽核結果建立第一條安全的工具路徑。
Herdr 解決的不是終端分頁:當 Agent 開始等你時,才需要 Runtime
從 Herdr 的近期實測與社群回饋出發,判斷何時 agent-aware terminal runtime 能降低等待與交接成本,何時 tmux 或 Zellij 已經足夠。
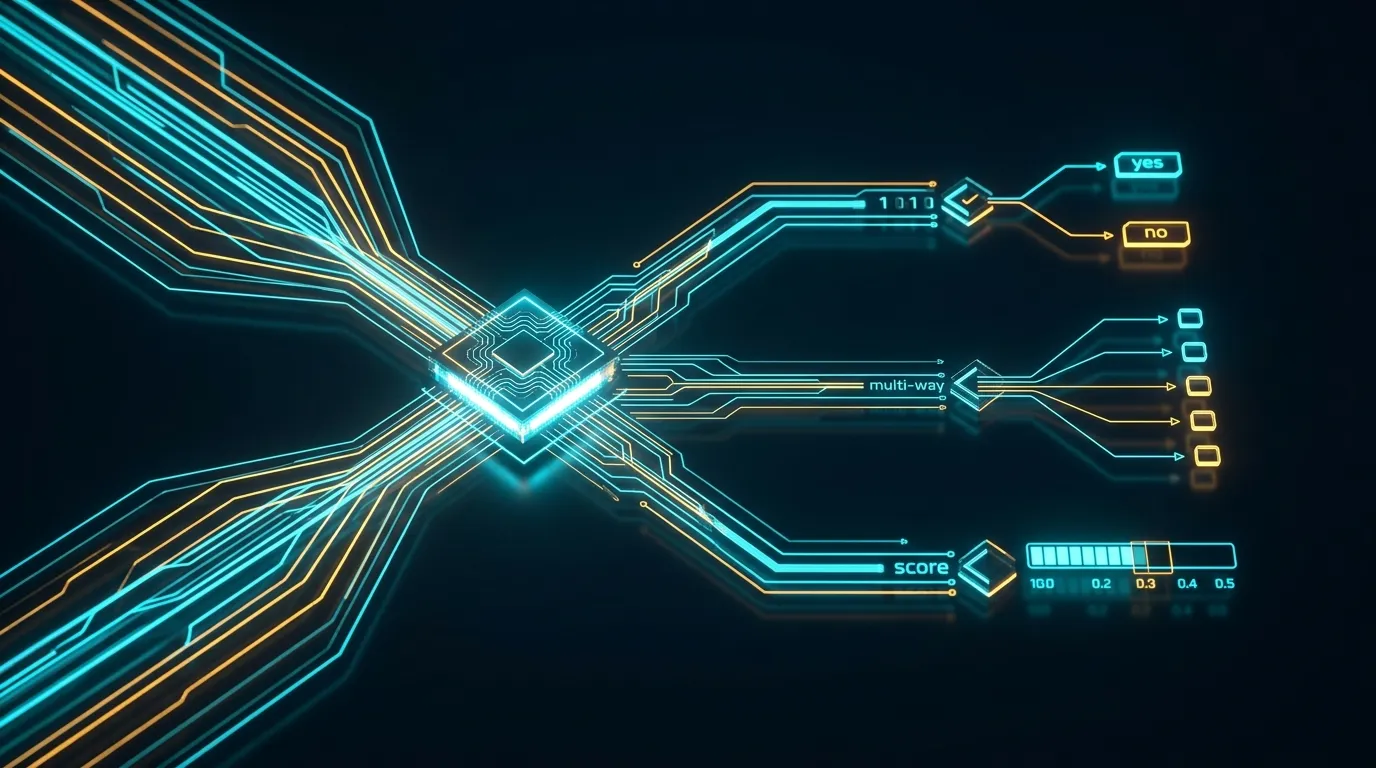
Agent 工作流不要再用 Chatbot 猜路由:從 TypeSafe AI Jev 看 System 1 決策模型的工程轉向
把生成式 LLM 拿來做布林判斷、模型路由與工具風險分流,會讓 Agent 工作流承擔不必要的延遲與解析失敗。從 Jev 的三種決策原語到 LangChain middleware,拆解 System 1 決策模型如何進入 Agent harness。
ADE 不是更酷炫的 IDE:從 Orca 看多 Agent 平行編排的 Git Worktree 隔離與控制面
當開發者開始同時調度 Claude Code、Codex 與 Cursor 等 Agent 艦隊,單一 working directory 必然走向鎖檔與狀態踩踏。從 Orca 的 ADE 架構切入,拆解 Git worktree 實體隔離、Zero-Proxy 自帶金鑰與 Tournament 審查合流機制。
把 Coding Agent 變成可遠端呼叫的受控服務:AgentPort 的派工閘門、狀態模型與邊界取捨
從開源專案 AgentPort 的架構設計出發,探討如何把本機 Claude Code 與 Codex 封裝為可遠端派工的 MCP 閘門;拆解為什麼查詢與取消必須獨立於執行佇列,以及單管理者專用主機的真實安全邊界。
Coding Agent 的成本要逐輪記帳:先縮減重複上下文,再決定模型升級
Google Cloud Tech 用六個回合示範 coding agent 的成本來源;本文區分示意試算與實測,整理可逐輪驗證的快取、工具輸出與模型路由方法。
Agent 要能並行,先把工作變成可驗收結果
從 Lauren Tan 的 Cursor Compile 分享與 Matt Pocock 訪談摘要,拆解可重跑的驗證環境、糾正落點與 pstack 的交付邊界:技能要實跑,驗收要對準最後提交,合併需要獨立授權。
DHH 在 Rails World 宣告停止手寫:Rails 還在,工程判斷換了位置
從 Rails World 2026 keynote 拆解 37signals 將 Agent 設為實作預設、HEY 新版重建計畫採用原生 App 與 Rust 郵件後端的說法,區分自述效能數字與可驗證結論,整理 Rails 的適用邊界和團隊驗收責任。
Copilot Agent Runtime 改寫成 Rust,真正移除的是 SDK 的 Node 子程序
拆解 GitHub Copilot agent runtime 從 TypeScript/Node.js 移植到 Rust 的原因、效能數據與漸進式驗收方法,並比較既有 runtime 移植與 Rust 原生 Agent 開發的差異。
讓 Agent 寫遊戲,先把回饋迴路做短
從 Three.js + TypeScript 的瀏覽器堆疊出發,建立遊戲 Agent 的型別檢查、玩法測試與瀏覽器驗收流程,再用同一個原型比較候選框架。
Claude Agent 的 effort 怎麼選:速度、驗證深度與 Token 成本
根據 Claude Code 官方文件與 Thariq 的 effort 實驗,整理 effort 如何影響驗證與自主程度,以及如何用固定任務確認省下的成本沒有變成品質損失。
使用者授權不等於網站同意:從 Meta Muse 看 AI Agent 的執行邊界
以 Meta Muse 的購物限制、macOS 安全漏洞與權限設計,拆解個人 AI Agent 必須通過的使用者授權、執行環境與第三方服務邊界,並整理可落地的拒絕處理與完成驗收規則。
Plan Mode 退場,規劃仍在:把決策放回 AI 執行迴圈
Ayman Nadeem 從 Nuanced 的產品復盤指出,規劃與完整計畫文件不是同一件事。本文對照 Claude Code 與 Codex 官方建議,整理如何依風險決定前置規劃,並用可中途修正的執行迴圈保留工程師的系統理解。
Coding Agent 要跨 Session 接手,得先保存任務狀態
綜合 Josh Rosen 對 coding-agent 架構的六項觀察,拆解編排、隔離、外部狀態、目標迴圈與 issue/PR 入口如何改變工作交接,並提供一份可驗收的任務紀錄草圖。
Vibe Coding 時代的品味霸權:當寫代碼免費,架構裁決權才是唯一護城河
AI 讓寫程式的邊際成本趨近於零,卻讓閱讀、驗證與架構裁決的代價成倍暴增。本文拆解社群共識與第一線工程反思,剖析為什麼「品味」不是感性玄學,而是以狹窄介面、失敗預期與堅決否定權構築的工程護城河。
當每個人都在 Vibe Coding,誰來守護 Production?Agent 時代的 DevOps 轉向與五道防禦邊界
AI 讓寫程式的邊際成本歸零,卻將「未通讀代碼」的海量 PR 直接推向生產環境。本文剖析維運懸崖的成因,探討 DevOps 如何從被動的管線修復者轉變為主動的平台編排者,並透過五道機器可驗證的 Guardrails 守住系統底線。
當每個人都在 Vibe Coding,敏捷開發還有必要嗎?儀式退場與短反饋迴圈的重生
AI 讓寫程式的邊際成本趨近於零,傳統兩週 Sprint 與點數估算正迅速淪為形式主義。本文剖析社群前線對「第 50 天維護懸崖」的反思,指出 Vibe Coding 解決了生成速度,而敏捷的核心不是開會,而是用架構邊界與短反饋迴圈守住方向。
別把 20 個 Agent 終端當成團隊:Paperclip 的心跳架構與 AI 組織治理模型
深入解析狂攬 9 萬星的開源專案 Paperclip:探討為什麼多 Agent 協作不能仰賴本機終端與無限背景輪詢,以及如何透過 Heartbeat 心跳調度、組織拓撲權限樹與預算硬圍欄建構生產級 AI 組織治理體系。
Agent 的計畫要能被程式推翻:用原型與型別草圖取代抽象 Plan
依 Lauren Tan 2026-09-09 的〈The Complete Guide to pstack Pt. 2〉與 pstack 0.15.5 原始檔,拆解重述、教學文件、原型、/architect 草圖與多階段計畫五個階段,並給一條決定何時寫計畫、何時做原型的停止規則。
AI Agent 的擴容單位,不該是整台沙盒
以 Tetral 的雲端 Agent runtime 設計為例,拆解工作狀態、可替換 runtime 與臨時電腦各自的生命週期,並整理驗證重試、恢復與背壓的檢查點。
OpenAI dots 把任務變成持續責任,驗收也得包含停止工作
整理 OpenAI dots 的首日發布與官方文件,拆解常駐 Agent、唯讀主動研究、委派任務與核准邊界,提供可直接試用的責任契約與停止驗收流程。
GPT-6.1 Sol 發布:換模型前,先量每個驗收任務的成本
整理 GPT-6.1 Sol 的發布資訊、API 遷移限制與價格條件,並把首日回饋轉成可執行的模型評估:比較驗收率、重試、延遲與人工修正成本。
Threat Signals 的工程啟示:抽取情報時,別切斷原文與決策的關係
Cloudflare 將 RSS 資安報告轉成私人威脅資料集。本文拆解來源追溯、受控標籤與 WAF 決策邊界,提出文件解析與知識庫工具可採用的資料契約及驗收案例。
Cloudflare 找出模型用得太重的任務,分流前仍要驗收品質
Cloudflare AI Gateway 於 9 月 29 日新增任務與模型分析。本文將 Potential Savings 轉成可驗證的分流流程:固定任務分類、重跑品質測試,再以版本化規則逐步導入。
Jeeves 能自架判斷服務,但 17 秒尾端延遲必須先過驗收
PostHog 的 9B 開源決策模型支援 Noul、多選與評分。拆解推理模式、公開基準的比較限制,以及如何用 Story 缺漏資料驗收漏判、校準與端到端延遲。
Gemini 4 Argon 擴大開放,長任務要把預算與權限一起驗收
依 Google 10 月 13 日公告更新 Argon 的統一輸入輸出額度與限時價格,將長任務的中斷恢復、工具權限和驗收責任整理成可執行的測試計畫。
GitHub HydraFusion 多模型編排:讓異質模型唯讀審查,終結同源盲點
GitHub 將 HydraFusion 擴展至 VS Code 與 Copilot App。拆解 Single、Cascade 階梯升級與跨家族 Critique 唯讀審查機制,說明如何以 TerminalBench 2.1 驗證並建立多模型派工的品質門檻。
Cloudflare Workers Issues:將邊緣日誌轉化為 Coding Agent 的可修復 Issue
Cloudflare Workers Issues 開放 Beta。剖析 V8 Runtime 原生錯誤聚合、Source Map 反組譯、Observability MCP Server 雙向探針,以及防範敏感日誌洩漏與重複 PR 的工程閉環。
Magnitude 本機推論引擎:用裝置端 Kernel 調校與 Radix Attention 釋放記憶體頻寬
開源推論引擎 Magnitude 登上 Launch HN。剖析其 On-Device Kernel Autotuning、TurboQuant 非對稱量化(8b K / 4b V)與 Radix 共享前綴快取機制,說明 Apple Silicon 解碼速度提升 92% 的工程底層。
npm Trusted Publishing 支援 dist-tag:把標籤維運權限另行驗收
npm Trusted Publishing 新增 opt-in dist-tag 權限。拆開平台授權與自訂 tag 白名單,規劃 OIDC 標籤維運、備援憑證盤點及發布管線的驗收。
Google Skills 取代 Gems:從孤島助理走向 SKILL.md 堆疊與企業遷移時程
Google 宣布以模組化 Skills 取代 Gems,採 SKILL.md 開放規範。拆解同一對話疊加多組技能的運作機制、Workspace 與 Gemini App 資料邊界隔離原因,以及 2027 企業停用時程的遷移策略。
EDG C++ 前端正式開源:35 年編譯器心臟入局,打破 Clang 單一壟斷
傳奇 C/C++ 編譯器前端 Edison Design Group (EDG) 宣布開源並由 The C++ Alliance 承接。剖析 Apache-2.0 with LLVM Exception 授權、極速建置、精準語義分析與 AST-to-Source 轉譯器的工程價值。
第一支 Claude Agent 團隊,先驗收交接與停止條件
從 Claude Opus 5.5 多代理教學出發,拆開研究、寫作與審查的資料依賴,釐清 tools 與 allowed_tools、預算與時間限制,建立可比較單代理基線的最小驗收流程。
Pi 開始支援 MCP:工具接得上之後,還要能組合
從 Earendil 將 MCP 納入 Pi 核心的決策,拆解按需工具發現、結構化結果與 Codemode 的分工,並用一條唯讀查詢驗證整合是否真的降低上下文與執行成本。
讓 Claude 自動調 prompt 前,先證明評分器值得相信
從 Claude 的 build-eval 與 hillclimb 工作流出發,建立評分器校準、資料隔離與停止規則,避免把測試集分數上升誤認為正式環境品質改善。
Claude 寫出影片程式後,先驗收每一幀的時間契約
從寶玉的 Claude 程式影片拆解出發,建立 Canvas 逐幀繪製、旁白時間對齊與 MP4 驗收流程,釐清可重播的程式為何仍需要渲染環境與人工審片。
Pi Durable 能接續任務,但重啟後的副作用仍要自己驗收
Pi 1.0 與實驗套件 Pi Durable 同日發布。從 checkpoint、工具重播與 requestId 的不同保證,區分結果重用與中途恢復,建立部署 Agent 的副作用去重、狀態一致性與人工介入驗收方法。
Clef 相容 Jev API,既有分流門檻仍需重新驗收
Cloudflare 發布 Clef 與 Clef-flash,提供 Jev 相容決策介面與開放權重。以客服分流遷移為例,檢查輸入截斷、機率門檻、人工佇列容量及圖片擴充,避免把 API 相容當成決策行為相同。
Karpathy 談 AI 解說:把人能否理解,寫進 Agent 的交付條件
從 Karpathy 的受控語言、圖解、互動 HTML 與解說影片建議出發,用重試機制審查說明如何選擇表達形式、保留證據,並以重述與反例驗收人的理解。
Claude Code 的 You should know:提醒要驗收漏報,沉默不能當通過
從 Claude Code 2.1.287 的內建觀察代理出發,釐清 You should know 的啟用條件、mods 權限與提醒邊界,再用可追溯案例檢查漏報、噪音及人工介入時機。
AI 的下一場競爭,是成為你不想更換的助理
從 OpenClaw、Grok Bot、OpenAI dots、Meta Muse 與 Gemini Spark 的產品方向,談我對主要助理位置、記憶與信任累積,以及 Agent 遷移成本的預測。
在 Cursor 導入 pstack,第一關是可重跑的修復
以 pstack 官方 Cursor plugin 0.15.6 原始檔為主,整理安裝、模型設定、新對話啟用、專案驗證技能,以及第一個本機 bug-fix 的驗收清單。從能載入技能,走到可重跑的修復證據。
中文技術寫作借用 STE:改短句之前,先保住條件與證據
從磊叔的中文技術寫作提案出發,釐清 ASD-STE100 的適用邊界,再用術語表、原句對照與停止規則,驗收 Agent 改寫後有沒有丟掉條件、否定與未驗證事項。
Uber MCP Gateway 的啟示:把工具上架當成一次受控發布
從 Uber MCP Gateway 的 Registry、虛擬 server 與按需發現設計,建立小團隊可驗收的工具發布契約:誰核准、何時撤權、如何處理舊 schema,以及如何量測整條任務的成本。
AI 越會寫程式,我們越需要學會抽象
從付款結果未知的語意差異,說明如何把需求整理成可驗收契約、讓 Spec 與 Story 保留限制,並以 Warrant 的減法和獨立商業案例檢查 AI 實作。
我為什麼做 AnswerMe:把 Vibe Coding 累積的理解債放回工作流程
從用 show me 生成本地暫存 HTML 的習慣,談我為何把理解債整理成 AnswerMe skill,以及來源依據、交付格式與解說驗證各自要負責什麼。
Strata 接上 Coding Agent:先驗工具迴圈,再算並行與記憶體的代價
Strata v0.1.39 新增 Responses API 與可選並行請求。本文區分作者量測與未實測範圍,拆解 Qwen3.8-Flash-Next 的硬體、量化與授權條件,並給出本機 Coding Agent 的延遲、吞吐、記憶體及工具相容驗收方法。
從 SEO 到 GEO:五道過濾關卡與 AI 爬蟲邊緣網關架構
從傳統搜尋引擎挑選藍色連結,到 ChatGPT、Claude 與 Perplexity 引用段落,拆解內容在邊緣網關、機器人識別與純文字端點必須通過的五道檢驗防線。
錄下 AnswerMe 的操作後,我更想讓人檢查解說從哪裡來
以 AnswerMe 的 TicketService 操作實錄和離線 HTML 成品,檢查 Agent 如何讀取程式、執行測試、指出 README 與實作的衝突,以及錄影本身不能證明什麼。
ReviewBench 把 AI 審查拆成兩筆帳:重大漏報與無效評論
從 GitHub 2026 年 10 月推出的 ReviewBench,核對 219 個 PR 的公開資料、grounded 與 augmented 指標及 LLM grader 限制,再把它轉成團隊可執行的 reviewer 驗收流程。
Deepagents 0.7.22:工具跟著 skill 出現,也要驗收它何時消失
從 Deepagents 0.7.22 的 SkillsMiddleware 實作,拆解按需揭露、MCP 工具群、Runtime 身分與 compaction 撤銷。用六個失敗案例驗收導入,區分工具可見性、實際授權與尚未量測的成本效益。
用 Decisions API 分流客服案件:分類、覆核與退款流程
以商品損壞案件說明 Decisions API 的 choice、probability、confidence 與拒答處理,整理 GA 升級、人工覆核、分類校準、退款檢查及成本計算。
mcp-use client 2.4.1 升級後連不上:先查最終端點與尾斜線
mcp-use client 2.4.1 帶入新的 HTTP/OAuth redirect 限制。從固定版本原始碼拆解 Node 與瀏覽器差異、尾斜線正規化陷阱,以及不把 token 送往錯誤目的地的驗收設計。
Cloudflare 資安 Agent:證據快照必須連同缺口一起驗收
從 Cloudflare 的資安調查架構出發,設計可重播的證據契約:固定租戶與時間範圍、區分查詢失敗和未命中、限制引用來源,再用合成案例檢查拒收規則與人工覆核邊界。
GPT-6 開始生成介面,核准必須綁定操作當下的狀態
從 GPT-6 Intelligent UI 與十月安全評估出發,設計受控元件、版本綁定的操作核准,以及警告後的停止驗收,避免介面更新悄悄擴大 Agent 的執行範圍。
Haiku 5.5 的 subagent 成本,要算到首次驗收與升級重跑
Haiku 5.5 帶來低價與可調 effort,但 subagent 是否省錢還取決於首次驗收率、100k 計價門檻與交接負擔。用一個可重算的成本案例,設計含升級、人工覆核與停止條件的窄任務實驗。
Grok Bot Guides 總覽:持久雲端電腦與多 Agent 協同的架構底座
全面拆解 xAI 官方 17 篇手冊的核心心法:Outer Loop 與 Inner Loop 解耦、雲端電腦共享登入的信任邊界,以及從自然語言 Reviewer 到可分享 Template 的工程模式。
Grok Bot Guides 工程篇:從單兵 Coding 到艦隊級研發 Harness 閉環
深度拆解 Grok Bot 官方工程手冊:管理 200 個 Cloud Agents 的專職編隊、一人獨立運營六 Bot 手機遊戲工作室,以及設計師如何讓 Agent 落地真實產品資產。
Grok Bot Guides 協同篇:一專案一頻道一看板的多 Agent 組織範式
從 Eric Zakariasson 的多團隊治理模式,到產品經理、創辦人業務與法務運營的自動化流水線:如何將 AI Teammates 組裝進現代組織架構。
OSS Scanner 送來漏洞之後,維護者需要一份驗證契約
Anthropic 開放未經人工審查的開源漏洞掃描報告。本文拆解 85/97 的適用範圍、重現與修補的不同責任,提出維護者可採用的報告狀態、威脅前提與停止規則。
Splunk MCP 漏洞揭露:工具目的地必須與執行者憑證分開授權
CVE-2026-76286 涉及 Splunk MCP Server 自訂 API 工具把執行者 token 送到設定的 URL。本文釐清管理與執行權限、1.2.1 修補範圍,並提出目的地、憑證與工具版本的驗收契約。
Claude Science 補全天圖之後,每個預測像素仍需要使用限制
全天紫外線圖整合觀測與統計預測,完整覆蓋不代表全面量測。本文釐清 Claude Science 與回歸模型的分工,從來源權重、空間驗證及解析度限制,設計補值資料的可追溯契約。
Prime Agent 改寫 Rust:先固定驗收行為,再擴大 Agent 平行度
Prime Agent 公開 Rust 重寫與差異測試流程。本文把啟動效能、行為一致性與執行權限拆開驗收,提供可執行的合成契約檢查,避免用 Agent 數量或啟動倍數代替重寫品質。
Grok Bot 額度治理:把省 Token 技巧落實成喚醒、委派與成本護欄
從鐵柱 AGI 的 Grok Bot 省額度指南,拆開週用量、外部執行池與任務總成本。用事件去重、委派契約與執行前預算檢查,驗證省下的額度沒有變成另一張帳單或更多返工。
500 行 Harness 跑出 CIFAR-10 成績後,還需要一份可驗收的執行收據
從 NotesByLex 的 CIFAR-10 範例,核對測試資料接觸、checkpoint 交付、人工介入與未入帳費用。用一份執行收據,分開判定產物完成、需人工與成本未知。
告別抽象方塊圖:Anatomy 讓 AI Agent 用等角精密機械重構架構視覺化
解析狂攬 3,600 星的 Claude Code 熱門開源 Skill『Anatomy』:探討為何傳統軟體工程圖表難以傳遞系統內核心智模型,以及如何透過實體機械等角圖、四階陰影與幾何審計,將限流、快取與共識演算法轉化為精密的實體機構。
Karpathy 的 AI 能力漏斗:先對齊觀測條件,再爭論模型能做什麼
Karpathy 用能力漏斗描述 AI 使用經驗的落差。本文將任務規模、可驗證性與存取層級轉成一份評估紀錄,讓團隊比較 Agent 能力時保留條件、失敗與人工成本。
Muse Wonder 的長任務能力,要用記憶失效與中途改單來驗收
Meta 推出 Muse Wonder 與 Wonder Full。從模型卡的 MemoryBench 與 SWE-Marathon 測試條件,建立跨回合訂單整合測試:舊需求失效、撤回操作、故障恢復,以及最終產物的獨立驗收。
多人共用 Agent 工作流,品質規則要做進 Repository
從 Composio 的 anti-slop software factory 經驗,拆解功能共置、端到端型別、可判定的 lint 與快速 CI,並釐清重複程式、React hooks 禁令和 Bugbot 各自適用的邊界。
Magpie 的錯題本:讓 Agent 復盤改變下一次驗收
查核 Magpie 的 LESSONS.md、code standards 與 PR #1339,拆解教訓升級、回退測試、未驗證項目和合併版本紀錄,並說明文件規則如何接上真正會阻擋錯誤的檢查。
Scion 給一般團隊的功課:先算 checkout 成本,再談換掉 Git
Anthropic 公開 Scion 的內部架構。以 CI 的檔案需求、歷史查詢與驗證佇列拆解 Agent 產碼增加後的瓶頸,說明何時保留 Git、何時值得做服務端卸載。
Grok Voice 3.0 自動遷移:語音 Agent 要把模型別名納入驗收
Grok Voice 3.0 已接手 grok-voice-latest。查核版本固定、首段音訊延遲與計價,整理語音客服升級需要的回歸案例、停止規則與降級安排。
AI 把付款錯誤修好了,為什麼客人還在等?
付款失敗的文案消失了,交易卻永遠停在處理中。從這個能騙過測試的修補,討論 Felix Rieseberg 的 AI 野心主張:任務交大之後,誰來證明問題已解決?
AI 審查越勤,PR 為什麼反而合不進去?
從 Claude Code 團隊的審查經驗出發,用退款 PR 拆解證據、誤報與重審邊界:如何讓 AI 抓錯,卻不讓它把修正工作無限延長。
同一個錯誤又出現在 PR,該改的是程式庫
統整 Lauren Tan 的四層倒金字塔,以多租戶匯出案例說明:把反覆的人工作業移到程式結構與可執行檢查,驗證技能留下證據,人審保留需求與風險決策。
搜尋找到網址,Agent 卻還沒有證據
DeepSeek 開放 Search 與 Fetch API 後,搜尋摘要、可讀原文與存取失敗需要不同處理。用一份供應商調查報告,拆出證據狀態、停止規則,以及帳號限速與逐次計費的工程取捨。
AI 寫完了刪檔任務,你能說出它何時會刪錯嗎?
Sphinx 把 committed diff 變成開卷問答。以虛構的延遲刪檔任務說明,如何把答不出的失敗情境轉成測試,以及為什麼理解檢查不能代替安全 gate、CI 或合併授權。
Agent 照著 skill 做完 TDD,為什麼修復品質沒有變好?
把 skill 評估拆成是否載入、是否遵循與是否改善結果。以折扣計算的修復案例,設計基線、技能與等長對照,辨認測試先行的收益、成本和無法下結論的情況。
評估器說 PASS,還不足以讓 Agent 過關
把 evaluator 的分數、判決門檻與機率校準拆開。從錯放與誤擋的示意案例,建立不放寬底線、不洩漏驗證資料的 Agent 驗收流程。
TorchTPU 打通 PyTorch 路徑,遷移驗收要量 shape 與 KV 搬運
Google 開源 TorchTPU,SGLang 同步推出原生 PyTorch TPU plugin。從 shape buckets、編譯快取與 KV 傳輸拆解採用成本,建立冷啟動、長尾延遲與正確性的遷移實驗。
Claude 寫出形式證明後,還要核對它證明的是哪個 binary
Anthropic 與 Theorem 將 OSS-Fuzz 入口轉成形式證明。分清研究規模、公開證明與部署產物,建立包含 binary、定理、機器模型及未涵蓋行為的驗收紀錄。
Agent Skills 移交 AAIF 後,團隊仍要自己固定版本與執行權限
Anthropic 將 Agent Skills 捐贈給 AAIF,版本發布與安全指引仍是提議路線圖。把標準治理、宿主相容性、技能版本與腳本授權分開驗收,避免把開放格式當成安全認證。
OpenAI 公開訓練環境隔離修補:DNS 與間接出網如何驗收
OpenAI 10 月 23 日說明訓練隔離修補與 10 月 1 日復訓。從 DNS 事件檢查直接連線、內部服務代抓取與自動停機,建立各自可驗證的測試證據。
MCP Toolbox 升級了,檔案與 Bucket 邊界仍要自己關上
CVE-2026-93328 揭露 cloud-storage 工具的檔案存取風險。從官方修補的預設允許行為,拆解版本、明確 allowlist 與執行身分如何共同決定工具能碰到哪些資料。
Cloudflare 的 KV cache 外洩:HTTP 200 驗不出請求隔離
拆解 Cloudflare 10 月 26 日披露的 GLM-5.3 跨請求資料曝露,說明 prefill/decode 分離後,容量檢查、拒絕傳遞與記憶體釋放如何共同構成租戶隔離。
Terra 適合接手哪些畫面操作?先分清可重做與已送出
GPT-6.1 Terra 把低價電腦操作帶進模型選型;用虛構採購錄入流程,拆開讀取、草稿與正式送出的路由,避免把重試成本變成重複下單。
ub-mode 把工程紀律寫成 skill,品質門檻還得接進 CI
拆解 Uncle Bob 的 ub-mode:TDD、小步驗證與三個品質工具各自負責什麼,為何 CRAP 10、重複度 0.8 和 mutation 結果不能直接當成自動放行條件,並用運費修改示範採用方式。
Ghostty 1.4 提醒我們,終端輸出也需要信任邊界
Ghostty 1.4.0 修補十項安全公告。從圖形協定解析、macOS 超連結與貼上保護三種觸發條件,整理開發機與 Agent 工作環境的升級、隔離及驗收方式。
LFM3 能放進本機,任務邊界仍要比模型更小
Liquid AI 發布 LFM3 小模型家族後,如何挑選適合本地處理的單一任務?從退款訊息分類出發,分開驗收模型記憶體、拒答、工具權限與升級處理成本。