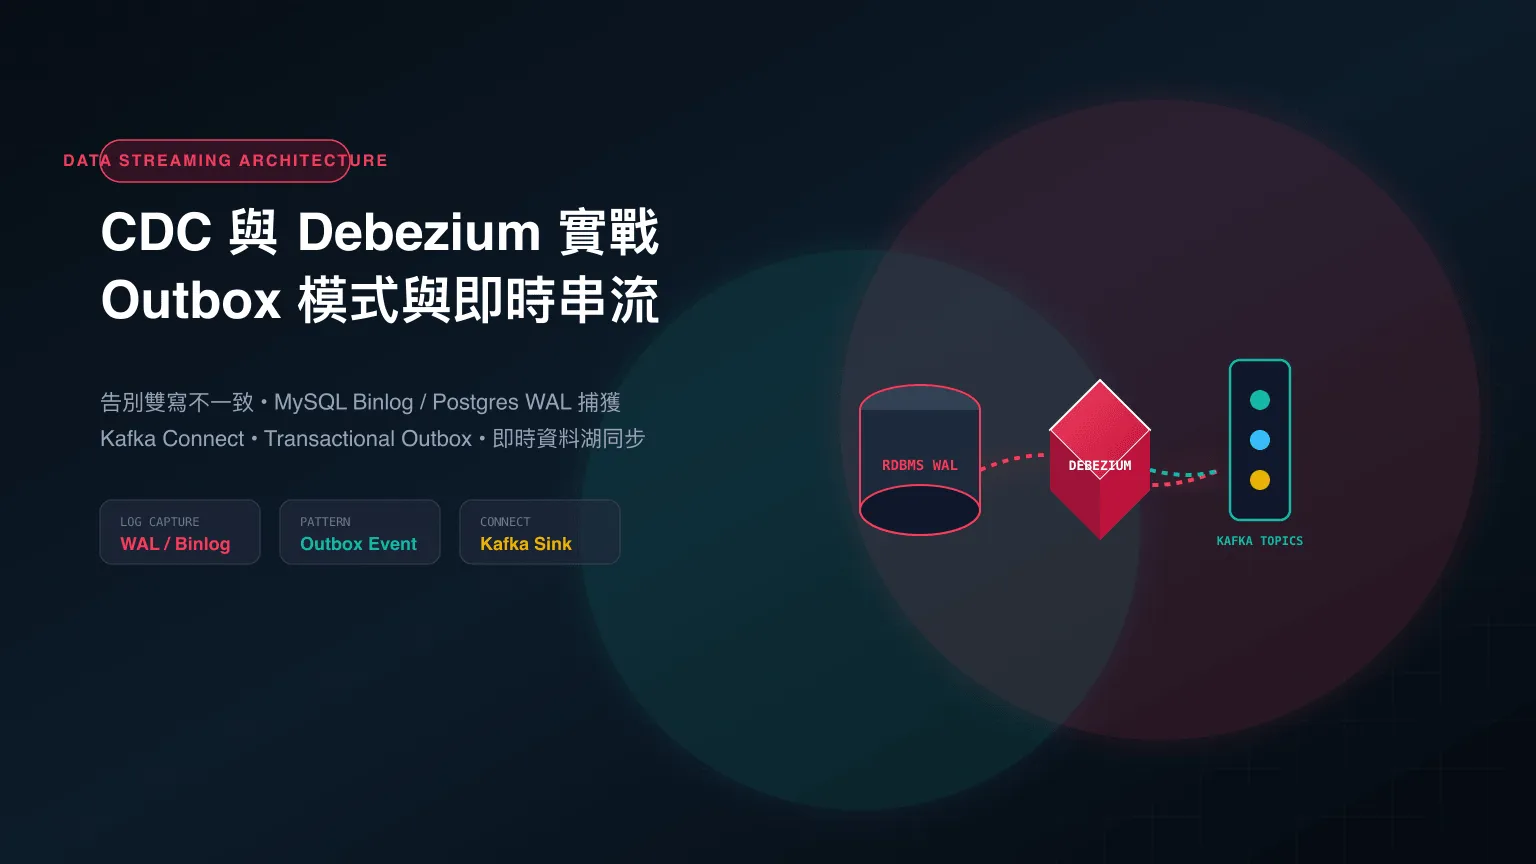
在微服務架構與現代資料密集型應用中,「資料變更同步」 是一個無所不在的剛性需求:
- 訂單建立後,需要即時失效 Redis 快取;
- 商品更新後,需要同步到 Elasticsearch 搜尋引擎;
- 業務資料庫(OLTP)中的數據變更,需要**即時串流至資料湖(ClickHouse / Apache Iceberg)**進行即時分析。
過去許多團隊採用應用層「雙寫(Dual-Write)」機制,但隨著併發升高與網路波動,雙寫必然導致嚴重的資料不一致與狀態遺失。
CDC(Change Data Capture,變更資料擷取) 搭配開源王者 Debezium 與 Transactional Outbox 模式,已成為業界解決異質系統同步與事件驅動架構(EDA)的標準基石。
本文基於 Debezium 官方架構文檔 與 ByteByteGo System Design 101,深入剖析 CDC 底層捕獲原理與生產級落地拓撲。
STEP 1: OUTBOX PATTERN
業務資料庫與 Outbox 表
業務變更與 Outbox 事件在同一 ACID 本地交易內寫入,徹底解決雙寫失敗與資料不一致。
↓ 讀取 WAL / Binlog 日誌
STEP 2: DEBEZIUM CDC
Debezium 引擎與 Kafka Connect
模擬 Replica 串流讀取日誌,透過 SMT 轉換扁平化事件並推送到對應 Kafka Topics。
↓ 串流分發與即時消費
STEP 3: STREAMING SINK
微服務、快取失效與資料湖
觸發 Redis 快取主動失效、ES 檢索同步,並將巨量資料即時寫入 ClickHouse / Iceberg。
一、為什麼應用層「雙寫(Dual-Write)」必遭滑鐵盧?
最直觀的同步做法是在業務程式碼中同時寫入資料庫與發送訊息佇列:
// 典型雙寫錯誤示範
func CreateOrder(order Order) error {
    // 1. 寫入關聯式資料庫
    if err := db.Save(&order); err != nil {
        return err
    }
    // 2. 發送領域事件至 Kafka / 更新 Redis
    if err := kafka.Publish("order-events", order); err != nil {
        // 痛點:DB 已提交,但 MQ 發送失敗!導致下游完全漏事件
        return err
    }
    return nil
}
雙寫無法避免的兩大死穴
- 原子性破裂(Partial Failure):
- 資料庫與 Message Queue 屬於兩個獨立的分散式系統。
- 若先寫 DB 成功、寫 MQ 失敗,下游永遠丟失變更;若先發 MQ 成功、DB 交易回滾,下游處理了幽靈資料。
- 傳統二階段提交(2PC / XA 事務)雖然保證原子性,但鎖資源時間過長,會將系統吞吐量拖垮 90% 以上。
- 競態條件導致順序錯亂(Out-of-Order Execution):
- 請求 A 將狀態更新為
PAID,請求 B 緊接著更新為CANCELLED。 - 由於網路排程與重試,請求 B 的 Kafka 訊息可能先於請求 A 到達下游,導致最終快取呈現錯誤的
PAID狀態。
- 請求 A 將狀態更新為
二、CDC 的兩大技術路線:Polling vs. Log-based
| 特性維度 | 查詢輪詢 (Polling CDC) | 日誌擷取 (Log-based CDC - Debezium) |
|---|---|---|
| 捕獲原理 | SELECT * FROM t WHERE updated_at > :last_time | 串流解析 MySQL Binlog / Postgres WAL |
| 即時延遲 | 較高(秒級到分鐘級,受輪詢頻率限制) | 極低(毫秒級,與主從複製同等延遲) |
| 硬刪除 (DELETE) | ❌ 無法捕獲(除非業務增加軟刪除欄位) | ✅ 完整捕獲(底層日誌記錄完整前像與後像) |
| 資料庫衝擊 | 週期性全表/索引掃描,佔用 DB 連線與 I/O | 幾乎零衝擊(模擬 Slave 讀取順序日誌) |
| 捕獲中間狀態 | ❌ 漏掉兩次輪詢間的頻繁多次修改 | ✅ 完整記錄每一次微小變更歷史 |
三、Transactional Outbox Pattern(交易發件匣模式)
如果某些領域事件包含豐富的跨聚合資料,直接解析業務表 Binlog 可能過於繁瑣。此時的最佳拍檔是 Transactional Outbox 模式:
-- 在同一個本地 ACID 交易內執行
BEGIN;
INSERT INTO orders (id, user_id, amount, status) VALUES (9001, 101, 299, 'CREATED');

-- 寫入發件匣表 (Outbox Table)
INSERT INTO outbox_table (
    id,
    aggregatetype,
    aggregateid,
    event_type,
    payload,
    created_at
) VALUES (
    gen_random_uuid(),
    'Order',
    '9001',
    'OrderCreated',
    '{"id":9001,"amount":299,"user_id":101}',
    NOW()
);
COMMIT;- 業務資料與 Outbox 事件在同一個 DB 本地交易中提交,100% 保證 ACID 原子性。
- Debezium 僅需監聽
outbox_table的變更日誌,並自動轉發至 Kafka。
四、Debezium 核心架構與 Kafka Connect
Debezium 是一套基於 Apache Kafka Connect 框架構建的分散式 CDC 連接器平台。
1. 底層日誌捕獲機制
- MySQL Connector:
- 要求 MySQL 開啟
binlog_format=ROW與binlog_row_image=FULL。 - Debezium 偽裝成 MySQL 叢集的一個 Replica 從節點,透過 binlog dump 協議即時拉取二進位串流。
- 要求 MySQL 開啟
- PostgreSQL Connector:
- 依賴 PostgreSQL 的**邏輯解碼(Logical Decoding)**功能與 Replication Slot。
- 使用內建的
pgoutput外掛,直接將 WAL 日誌解碼為結構化資料流。
2. SMT(Single Message Transform)事件路由
Debezium 內建強大的 Outbox Event Router 轉換外掛:
- 自動提取 Outbox 表中的
aggregatetype作為目標 Kafka Topic 名稱(例如自動路由至OrderTopic)。 - 將
aggregateid設為 Kafka 訊息的 Partition Key,確保同一訂單的所有事件按順序寫入同一 Kafka 分區。 - 自動解開外層包裝,直接輸出純淨的業務 JSON Payload。
五、生產環境關鍵高可用設計
- 初始全量快照(Initial Snapshot)與增量無縫切換:
- 當 Debezium 首次啟動時,會先對現有資料進行一致性讀取(Snapshot),記錄當時的日誌位移(Binlog Position / LSN)。
- 快照完成後,自動無縫切換至增量日誌追蹤,不遺漏任何歷史資料。
- Exactly-Once 語義與冪等消費:
- CDC 在網路重連或重啟時遵循 At-least-once(至少一次交付)。
- 下游消費者必須基於事件的唯一 ID(如 Outbox UUID 或 Entity ID + Version)實現冪等消費。
- Schema 演進(Schema Evolution)相容性:
- 結合 Confluent Schema Registry / Apicurio Registry 使用 Avro 或 Protobuf 格式。
- 確保上游資料表增加欄位時,下游消費端具備向後相容性(Backward Compatibility)。