軟體品質
70 篇文章
ub-mode 把工程紀律寫成 skill,品質門檻還得接進 CI
拆解 Uncle Bob 的 ub-mode:TDD、小步驗證與三個品質工具各自負責什麼,為何 CRAP 10、重複度 0.8 和 mutation 結果不能直接當成自動放行條件,並用運費修改示範採用方式。
PHP 10 月安全更新:驗收 Web worker,並檢查 session handler 切換
PHP 10 月 21 日修補兩項 RCE,23 日另公告特定 session handler 切換條件下的 CVE-2026-115560。分開確認修補版本、upload progress 設定與承接 HTTP 流量的 worker。
Claude 寫出形式證明後,還要核對它證明的是哪個 binary
Anthropic 與 Theorem 將 OSS-Fuzz 入口轉成形式證明。分清研究規模、公開證明與部署產物,建立包含 binary、定理、機器模型及未涵蓋行為的驗收紀錄。
GitLab 緊急修補要驗收到工作流,19.3 分支目標已改為 19.3.5
核對 GitLab 十月修補的 RCE 與 Duo 提示注入條件,分開處理版本到位、升級回復與權限驗收,避免把套件更新成功當成事件結案。
GitLab regex RCE 的調查缺口:崩潰請求不一定留下 Rails 日誌
GitLab 10 月 21 日修補 CVE-2026-110264。從官方 Onigmo 與 Org-mode 偵測規則,檢查 Rails、Workhorse、Puma 日誌覆蓋,分清修補到位與調查證據不足。
評估器說 PASS,還不足以讓 Agent 過關
把 evaluator 的分數、判決門檻與機率校準拆開。從錯放與誤擋的示意案例,建立不放寬底線、不洩漏驗證資料的 Agent 驗收流程。
Xcode 升級後測試全綠,CodeQL 仍可能沒有完成掃描
GitHub 說明 macOS 27、Xcode 27 與 Swift 6.4 的 CodeQL 相容限制。從 runner 版本、traced extraction 到掃描結果驗收,拆開保留舊工具鏈與 build-mode: none 的適用範圍。
Agent 照著 skill 做完 TDD,為什麼修復品質沒有變好?
把 skill 評估拆成是否載入、是否遵循與是否改善結果。以折扣計算的修復案例,設計基線、技能與等長對照,辨認測試先行的收益、成本和無法下結論的情況。
AI 寫完了刪檔任務,你能說出它何時會刪錯嗎?
Sphinx 把 committed diff 變成開卷問答。以虛構的延遲刪檔任務說明,如何把答不出的失敗情境轉成測試,以及為什麼理解檢查不能代替安全 gate、CI 或合併授權。
同一個錯誤又出現在 PR,該改的是程式庫
統整 Lauren Tan 的四層倒金字塔,以多租戶匯出案例說明:把反覆的人工作業移到程式結構與可執行檢查,驗證技能留下證據,人審保留需求與風險決策。
Agent 加進來的套件,授權例外要交給另一個人
GitHub 開源授權合規功能正式推出。從 Agent 選套件到 PR 合併,拆開預查、依賴圖檢查與例外審核,避免讓修復檢查的人同時放寬政策。
GitHub Actions 鎖檔擋住 tag 漂移,審查仍要追進共用工作流
GitHub Actions workflow lockfiles 進入公開預覽。拆開可變 tag、間接 action 與 reusable workflow 的鎖定範圍,並用逐步導入、完整 diff 審查與停止規則,避免把固定 SHA 誤當成依賴安全保證。
Cisco 郵件閘道修補,元件版本與入侵復原要分開驗收
CVE-2026-76519 已遭利用。從 Content Scanner Tools 修補條件出發,區分更新成功、疑似入侵與乾淨重建,避免用一個完成欄位掩蓋尚未結案的調查。
Ivanti 已遭利用漏洞的修補,要逐台核對分支與完成證據
CVE-2026-104935 已列入 CISA KEV。整理 Connect Secure 分支修補目標與來源差異,將設備盤點、更新驗收及事件調查分開追蹤。
Scion 給一般團隊的功課:先算 checkout 成本,再談換掉 Git
Anthropic 公開 Scion 的內部架構。以 CI 的檔案需求、歷史查詢與驗證佇列拆解 Agent 產碼增加後的瓶頸,說明何時保留 Git、何時值得做服務端卸載。
寫過的爛 Code,要回頭看才會變成經驗
從菜鳥阿哲的一份訂單報表,寫他如何在漏改、錯誤測試與過度共用之間,逐步學會辨認需求、保留反例,讓寫過的程式長成下一次的判斷力。
Magpie 的錯題本:讓 Agent 復盤改變下一次驗收
查核 Magpie 的 LESSONS.md、code standards 與 PR #1339,拆解教訓升級、回退測試、未驗證項目和合併版本紀錄,並說明文件規則如何接上真正會阻擋錯誤的檢查。
多人共用 Agent 工作流,品質規則要做進 Repository
從 Composio 的 anti-slop software factory 經驗,拆解功能共置、端到端型別、可判定的 lint 與快速 CI,並釐清重複程式、React hooks 禁令和 Bugbot 各自適用的邊界。
Agent 要能並行,先把工作變成可驗收結果
從 Lauren Tan 的 Cursor Compile 分享與 Matt Pocock 訪談摘要,拆解可重跑的驗證環境、糾正落點與 pstack 的交付邊界:技能要實跑,驗收要對準最後提交,合併需要獨立授權。
Muse Wonder 的長任務能力,要用記憶失效與中途改單來驗收
Meta 推出 Muse Wonder 與 Wonder Full。從模型卡的 MemoryBench 與 SWE-Marathon 測試條件,建立跨回合訂單整合測試:舊需求失效、撤回操作、故障恢復,以及最終產物的獨立驗收。
Conduit 修掉 CDC 靜默停滯後,Running 仍需要一份進度證明
從 Conduit v0.20.0 的 snapshot/CDC 交接修復,設計來源位移、sink 水位與 canary 驗收;用故障注入確認重播、停止與恢復,避免把 Running 當成資料已送達。
500 行 Harness 跑出 CIFAR-10 成績後,還需要一份可驗收的執行收據
從 NotesByLex 的 CIFAR-10 範例,核對測試資料接觸、checkpoint 交付、人工介入與未入帳費用。用一份執行收據,分開判定產物完成、需人工與成本未知。
GPT-6 開始生成介面,核准必須綁定操作當下的狀態
從 GPT-6 Intelligent UI 與十月安全評估出發,設計受控元件、版本綁定的操作核准,以及警告後的停止驗收,避免介面更新悄悄擴大 Agent 的執行範圍。
我為什麼做 AnswerMe:把 Vibe Coding 累積的理解債放回工作流程
從用 show me 生成本地暫存 HTML 的習慣,談我為何把理解債整理成 AnswerMe skill,以及來源依據、交付格式與解說驗證各自要負責什麼。
AI 越會寫程式,我們越需要學會抽象
從付款結果未知的語意差異,說明如何把需求整理成可驗收契約、讓 Spec 與 Story 保留限制,並以 Warrant 的減法和獨立商業案例檢查 AI 實作。
中文技術寫作借用 STE:改短句之前,先保住條件與證據
從磊叔的中文技術寫作提案出發,釐清 ASD-STE100 的適用邊界,再用術語表、原句對照與停止規則,驗收 Agent 改寫後有沒有丟掉條件、否定與未驗證事項。
Karpathy 談 AI 解說:把人能否理解,寫進 Agent 的交付條件
從 Karpathy 的受控語言、圖解、互動 HTML 與解說影片建議出發,用重試機制審查說明如何選擇表達形式、保留證據,並以重述與反例驗收人的理解。
Agent 值得更多好抽象:用深模組收斂決策,用 lint 守住入口
從 Matt Pocock 對抽象與嚴格 lint 的主張,檢查深模組、接縫與領域語言如何減少呼叫端決策;用一組 ESLint 正反例驗收邊界,並區分 token 假說、重構成本與業務正確性。
在 Cursor 導入 pstack,第一關是可重跑的修復
以 pstack 官方 Cursor plugin 0.15.6 原始檔為主,整理安裝、模型設定、新對話啟用、專案驗證技能,以及第一個本機 bug-fix 的驗收清單。從能載入技能,走到可重跑的修復證據。
Claude Code 的 You should know:提醒要驗收漏報,沉默不能當通過
從 Claude Code 2.1.287 的內建觀察代理出發,釐清 You should know 的啟用條件、mods 權限與提醒邊界,再用可追溯案例檢查漏報、噪音及人工介入時機。
Uncle Bob 不看 Agent 寫的 code:真正被審查的是哪一層?
Robert C. Martin 的 Agentic Discipline 把高層規格、專職 agent、Gherkin、coverage、mutation testing 與 UI QA 串成品質閘門;本文拆解它如何落地,以及哪些責任仍不能交給指標。
排查不是猜測:生產級 Kubernetes 故障的 5 步定位法與防禦型探針設計
直覺式重啟 Pod 往往是二次雪崩的開始。本文從現場 SRE 排錯鏈路出發,拆解從 Pod 生命週期、退出碼、探針合約到主機 cgroups 的 5 步定位迴圈,並給出停止規則與防禦型探針架構。
能用 CI 與 Hook 鎖死的規則,絕不留在 Prompt 裡:從第一性原理談 AI 工程邊界
從亞里斯多德形式因到 Nancy Leveson 系統控制論,剖析為什麼「在 Prompt 裡千叮嚀萬囑咐」是軟體工程的幻覺,並示範如何以靜態防線、沙盒與動態控制迴圈重塑 AI Agent 工作區。
Agent 的計畫要能被程式推翻:用原型與型別草圖取代抽象 Plan
依 Lauren Tan 2026-09-09 的〈The Complete Guide to pstack Pt. 2〉與 pstack 0.15.5 原始檔,拆解重述、教學文件、原型、/architect 草圖與多階段計畫五個階段,並給一條決定何時寫計畫、何時做原型的停止規則。
長任務不要從聊天紀錄續命:用驗收證據讓 Agent 接著交付
以 Microsoft Argus 與一個公開效能 PR 為例,拆解長時間 Agent 工作真正需要保存的狀態、獨立審查與停止規則;用最小任務契約判斷何時值得增加一層 runtime。
當每個人都在 Vibe Coding,誰來守護 Production?Agent 時代的 DevOps 轉向與五道防禦邊界
AI 讓寫程式的邊際成本歸零,卻將「未通讀代碼」的海量 PR 直接推向生產環境。本文剖析維運懸崖的成因,探討 DevOps 如何從被動的管線修復者轉變為主動的平台編排者,並透過五道機器可驗證的 Guardrails 守住系統底線。
Vibe Coding 時代的品味霸權:當寫代碼免費,架構裁決權才是唯一護城河
AI 讓寫程式的邊際成本趨近於零,卻讓閱讀、驗證與架構裁決的代價成倍暴增。本文拆解社群共識與第一線工程反思,剖析為什麼「品味」不是感性玄學,而是以狹窄介面、失敗預期與堅決否定權構築的工程護城河。
當程式碼不再是瓶頸:AI Native SDLC 真正要重構什麼
交叉比較 Google、OpenAI、Anthropic 與 LangChain 的軟體開發方法,拆解意圖、驗證、治理與生產回饋如何接手程式碼生成後的新瓶頸。
Plan Mode 退場,規劃仍在:把決策放回 AI 執行迴圈
Ayman Nadeem 從 Nuanced 的產品復盤指出,規劃與完整計畫文件不是同一件事。本文對照 Claude Code 與 Codex 官方建議,整理如何依風險決定前置規劃,並用可中途修正的執行迴圈保留工程師的系統理解。
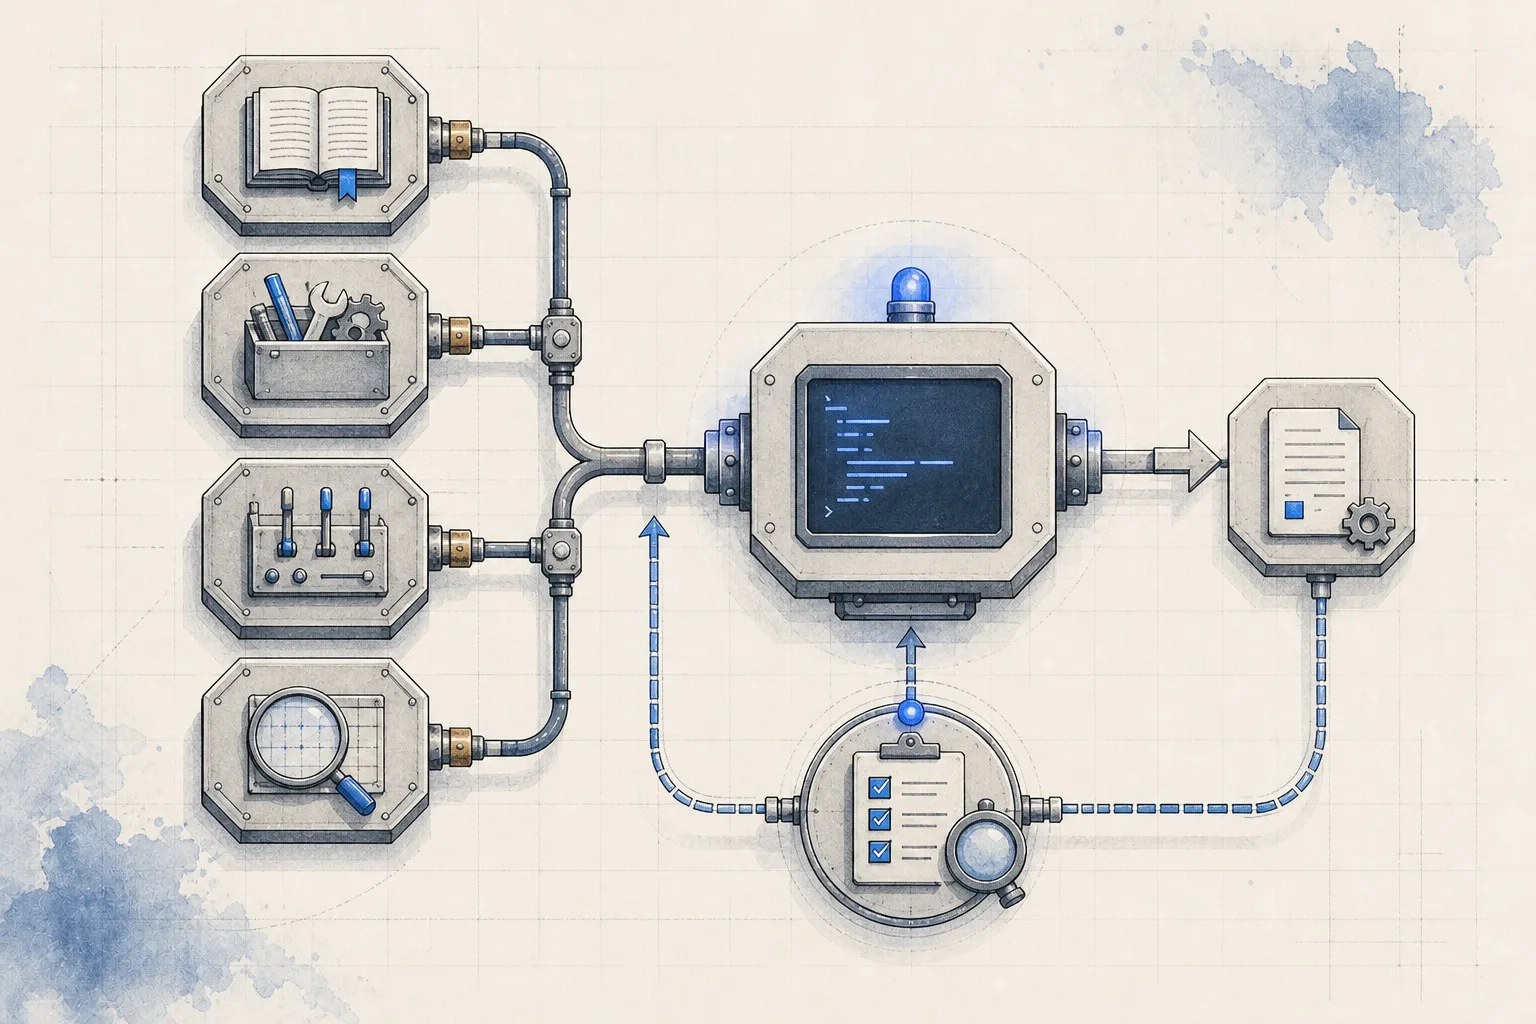
AGENTS.md 不是越長越好:把 Agent 規則變成可驗證的開發環境
從 AGENTS.md、CLAUDE.md、Skills、hooks 到 evals,整理如何刪除過期指令、按需載入工作流程,並用失敗案例維護 Agent 上下文。
部署控制器不該猜服務狀態:用 Hayek 的知識問題劃分中央與在地權限
從 Friedrich Hayek 對分散知識與即時情境的分析出發,拆解多服務部署中哪些規則應集中、哪些停啟決定應留在服務現場,並給出可驗收的權限與回復邊界。
Benchmark 結果要帶著成立條件:用 Cartwright 限定效能測試能證明什麼
從南希・Cartwright 的 nomological machine 與因果外推問題出發,檢查 workload、執行環境和作用機制如何限制 benchmark 的適用範圍,並建立連到 production-shape 驗證的決策步驟。
例外處理要先決定誰負責:用亞里斯多德實踐智慧設計自動化停點
從《尼各馬科倫理學》VI 的實踐智慧出發,把例外拆成資料尚未確定、規則已明確與真正需要判斷的情況,設計自動停點、責任人與可稽核的決策紀錄。
Claude Agent 的 effort 怎麼選:速度、驗證深度與 Token 成本
根據 Claude Code 官方文件與 Thariq 的 effort 實驗,整理 effort 如何影響驗證與自主程度,以及如何用固定任務確認省下的成本沒有變成品質損失。
讓 Agent 寫遊戲,先把回饋迴路做短
從 Three.js + TypeScript 的瀏覽器堆疊出發,建立遊戲 Agent 的型別檢查、玩法測試與瀏覽器驗收流程,再用同一個原型比較候選框架。
Claude Code 沒遵守 AGENTS.md?先確認檔案真的載入
Claude Code 2.1.277 至 2.1.280 的部分 session 會在關閉 telemetry 時略過 AGENTS.md。本文拆開版本與設定條件,提供載入檢查、升級與單一來源的替代做法。
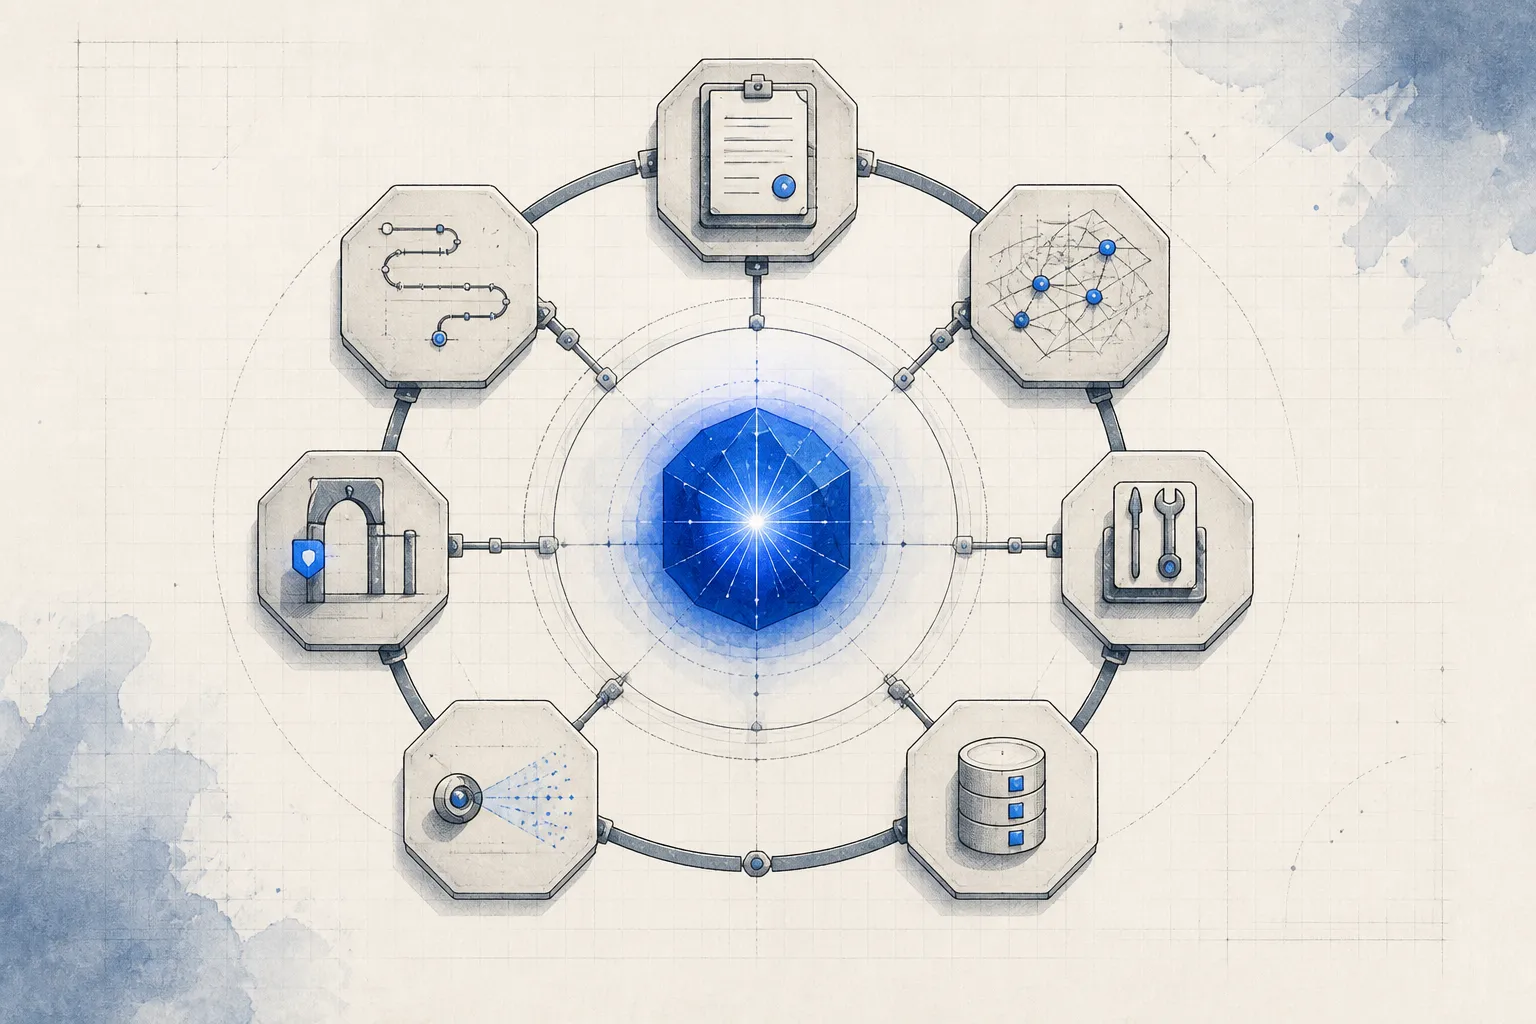
AI Agent 不可靠,先別急著換模型:Harness Engineering 的七個控制面
從多篇 Harness Engineering 實務出發,拆解任務契約、工具、持久狀態、驗證、權限與追蹤如何把模型能力變成可交付的系統。
Claude 不能用時,先分類故障:額度、帳單、登入、網路與帳號停用
把 Claude 與 Claude Code 的五類常見故障分開,依官方文件建立排查順序,避免把額度用完或本地登入失效誤認為封號。
別讓 Agent 偽造世界:如何用 Seam 與 In-Memory Fake 終結 AI 的 Mock 地獄?
深入探討 AI Agent 開發中最嚴重的測試架構陷阱:為什麼 LLM 依賴 jest.mock 與脆性打樁會導致幻覺蔓延?解析 Michael Feathers 的接縫哲學、雙轉接器準則,以及如何用 In-Memory Fake 建構極速、確定性的 TDD 驗證體系。
別把改變寫成新年願望:把目標做成能校正的回饋迴路
從 Dan Koe 的長文出發,將身分認同與人生目標的敘事收斂成工程上可執行的最小閉環:定義狀態、量測差距、調整下一個行動。
Claude 工作環境別一次裝滿:先把可重用的 context 與核准邊界排好
從 Claude 的 memory、projects、skills、connectors 到排程與瀏覽器操作,建立一條由低副作用到可驗收自動化的採用順序,避免把「少重複貼 context」誤當成「可以自動代表你行動」。
模型變強後,Harness 該先刪什麼:保留外部狀態與可驗收證據
把模型升級當成一次 Harness 消融測試:刪除只補模型弱點的固定流程,保留外部狀態、權限與獨立驗收,並用四組對照量出真正收益。
AI 回答很快,但代價可能慢慢出現:用二階思考設計使用方式
把「然後呢?」變成 AI 工作流的固定檢查:區分交付、判斷與學習任務,在速度之外保留驗證、能力與資料邊界。
AI 協作不會自己複利:把每次交付變成下一次可驗證的輸入
把 AI 協作中的需求邊界、長期規則、驗證結果與重複失敗分開保存,建立能減少重複說明、也不會把舊錯誤自動放大的最小回饋迴圈。
Vibe Coding 上線前,別問「安全嗎」:交出七項可重跑的證據
把公開網站的安全驗收收斂成七項可重跑結果:帳號隔離、後端授權、併發計費、付款冪等、資源上限、憑證輪換與覆蓋缺口。它們不能取代安全審計,但能阻止「功能能跑」被誤當成可以上線。
別先裝 19 個 Skill:把 Agent 能力當成有權限的工作契約
從一份 Hermes Skill 清單出發,建立 Agent 能力的最小採用門檻:明確痛點、最小權限、可觀察證據與移除規則。用這個門檻逐步加能力,避免把可用的 Agent 變成無法審計的工具抽屜。
AI Coding 入門不是做出網頁:用三個可驗收專案學會交付
把 AI Coding 的學習順序收斂為三個可驗收專案:先看懂改動,再處理狀態,最後交付有資料與權限的產品;每一步都留下可以重跑的證據。
AI 能生成程式碼後,工程基本功決定你怎麼驗收
從 Bilgin Ibryam 的八本軟體書閱讀地圖出發,將 AI coding 後仍須由工程師承擔的產品、規格、架構、資料、安全、韌性與交付決策,收斂成八個可驗收問題。
Skill 不會死:把 Agent 指令縮成可驗證的方法,而不是更短的咒語
從「Skill 將死,方法論永生」的八個工程方法出發,建立 Agent 任務的最小契約:問題、方法、證據與停止規則,淘汰重複的通用說明,保留模型外的可驗證邊界。

DHH 談 Agentic Engineering:當實作不再稀缺,決策如何成為工程瓶頸
從 DHH 在 Lex Fridman Podcast #501 對 Omarchy、vibe coding 與小團隊的觀察,整理 Agent 加速後仍必須由人承擔的產品判斷、架構責任與決策節奏。
Agent 還在跑,不代表任務還活著:長時間 AI Agent 的五種靜默失敗
Google Cloud Tech 的 Long Horizon harness 整理五種不一定拋錯的失敗模式,本文把它們改寫成可注入、可量測的 failure probes。
Coding Agent 不是自動駕駛:用權限與證據管理自治
Andrew Ng 的 Coding Agent 技能地圖提醒我們,真正要設計的是責任邊界:哪些工作可委派、哪些權限要收回,以及什麼證據才足以交付。
本機 AI Agent 不等於離線模型:從 3,615 次 Turn 重畫執行邊界
盤點 1,447 個 threads、3,615 個 turns 與 32,856 次指令執行後,我把本機 AI Agent 拆成資料選取、工具、權限與驗收四道邊界。
Claude Code 500 多次派工復盤:刪光自訂 Command 後,我只留三層工作流
比較 7 支自訂 Command、9 個專用 Agent 與 546 次實際派工後,我刪掉沒人使用的入口,只留下模型分層、情境型 Skill 與一條手動規格化管線。
Claude 的記憶與排程不會自動複利:把重複工作變成可驗證閉環
以 Claude 的持久脈絡與排程工作為例,說明如何定義輸入、輸出、驗收與升級條件,避免把背景執行誤當成可靠自動化。
產品經理 Agent 不等於 21 個 Skill:把產出接成可驗收工作流
從一則以 Codex 串接調研、原型、PRD、預審與埋點的實作出發,整理產品工作如何用 artifact、驗收 gate 與明確 handoff 形成可檢查流程。
快取不是正確性保證:Uber 如何用 Validation Proxy 現代化建置產物交付
從 Uber 2026 年的 artifact storage 現代化案例,拆解高頻下載下為何 TTL cache 不夠、如何以 HTTP 條件驗證維持 origin 為唯一真相,以及失效時該怎麼安全降級。
25 個 AI Skills 真的能跨 Claude、ChatGPT 與 Gemini 使用嗎?
拆解一份 25 個生產力 Skills 清單,釐清 Markdown Prompt、Agent Skill 與跨平台可攜性的差別,並整理把高頻任務做成可驗證 Skill 的最小方法。
盡職程式設計:AI Coding 時代個體產出差異的真正來源
當每個人都能使用強大的程式碼模型時,工程產出的差距從何而來?拆解需求契約化、架構接縫判讀、獨立審查與上下文治理的關鍵責任。
Trace Engineering:自主 AI Agent 的可觀測性與除錯架構
當 Agent 在背景執行多輪任務時,單靠一般 Log 不足以釐清決策脈絡。從因果追蹤、故障環境重播到驗證收據,拆解生產級 Agent 的 Trace Engineering 實踐。