大型建置系統裡,artifact repository 常被當成「放 JAR、npm package、container layer 的地方」。等到每次 build 都要抓數百個依賴、同一份 binary 被重複下載,才發現它其實在 CI 的關鍵路徑上:慢一點會拖住所有 build,拿錯一份又會直接損害可重現性。
Uber 在 2026 年 5 月公開的 artifact storage 現代化案例提供了一個很好的切面。他們從雙資料中心、自管本機磁碟的 artifact 平台,遷移到 managed SaaS origin;但因為每月下載量超過 5 PB,不能讓每次讀取都把完整 bytes 從雲端取回。關鍵不是再加一個「快取」,而是加一個 validation proxy:每次讀取都先向 origin 驗證內容是否仍是最新版,只有 origin 明確回覆未變更時,才從本機快取取 bytes。
這是 Uber 在其規模和協定條件下的設計,不是所有團隊都該複製的產品清單。但它把一條常被忽略的邊界說得很清楚:成本最佳化可以快取,正確性仍要有權威來源。
問題不只是 disk,而是恢復與升級風險
Uber 的舊系統在兩個資料中心各有五節點叢集,replication factor 是 3;寫入後以非同步複寫同步到其他節點,再以排程工作補足複寫缺口。隨規模增加,本機 disk 空間、手動 rebalancing、硬體替換、長時間 backfill 和多 TB schema migration 都成為風險來源。原文特別指出,背景複寫可能失敗卻沒有即時可見性,導致某個 artifact 只存在單一節點上。Uber 的舊架構與故障描述
遷移到 managed platform 解除了節點本機儲存、平台升級與 patch 維護的一部分責任,卻帶來另一個現實:每次重新抓同一份內容都可能產生 egress 成本。這類遷移不是「on-prem 換雲端」的二選一;它把可靠性責任重新切分,並把反覆傳輸的成本推到讀取路徑。
TTL cache 為什麼不足以處理 artifact
一般 HTTP cache 用 TTL 很合理:在一段時間內,願意以可能讀到舊資料換取低延遲與低成本。但 artifact delivery 的語意常更嚴格。若同一 URL 的內容可能被更新、修補或撤回,TTL 尚未到期時提供舊 bytes,就是「快」卻不一定「對」。
這不是假設。Google Cloud Storage 的文件也明說:允許快取的公開物件,更新或刪除後,cache 在 lifetime 到期前可能仍提供舊版本。Google Cloud Storage:Cache control and consistency
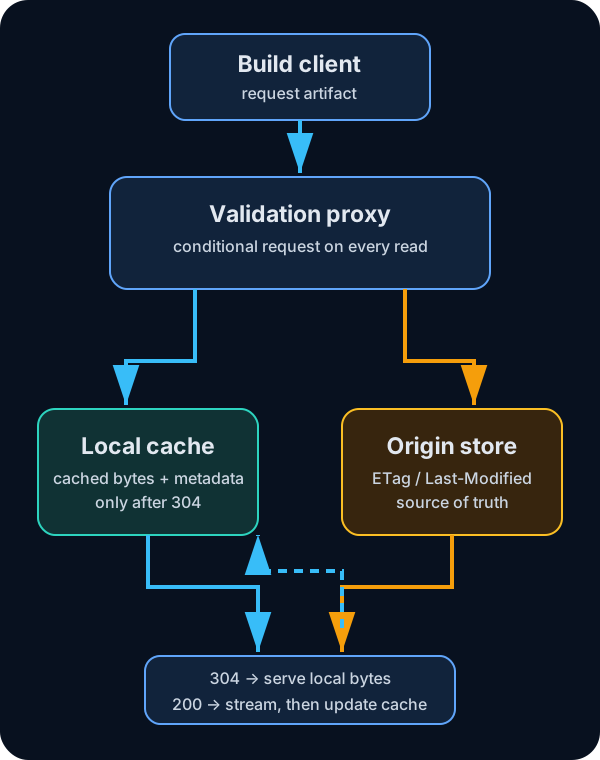
Uber 因此沒有直接採用通用 HTTP caching proxy 的 TTL 與 best-effort eviction 語意。他們讓 proxy 保存 artifact URL、checksum、last-modified 等 metadata,但每個 client request 都轉成對 SaaS origin 的 conditional request:
- 帶上
If-None-Match或If-Modified-Since; - origin 回
304 Not Modified,proxy 才從本機 cache 回傳 bytes; - origin 回
200 OK,proxy 一邊把新 bytes 串流給 client,一邊非同步更新 cache。
RFC 9110 的條件請求定義了這種「用已知 representation 的 validator 請 server 判斷是否仍可使用」的 HTTP 語意。Uber 的實作特別之處不是發明協定,而是把它放進 artifact 的讀取關鍵路徑,讓 cache 只是 bytes 的加速層,而不是版本真相的裁判。
把 metadata control plane 與 bytes data plane 分開
這個設計最值得帶走的地方,是它刻意讓兩種資料承擔不同責任:
| 層 | 保存什麼 | 判斷什麼 |
|---|---|---|
| Origin | artifact 的權威內容與 validator | 客戶端持有的版本是否仍有效 |
| Proxy metadata | URL、checksum、ETag/last-modified 等 | 可否提出正確的條件驗證 |
| Local cache | 已驗證過的 artifact bytes | 可否省下完整資料傳輸 |
所以「cache hit」不等於「不用碰 origin」。它代表可以避免重傳大檔;版本是否有效仍由小型 metadata request 決定。這比把快取變成另一個需要自行複寫、修復與對帳的 source of truth 簡單得多。
原文也保留了實際的限制:Range request、超大物件、熱門 artifact 的 thundering herd、request coalescing 與 backpressure 都是下一步,並非已經完成的能力。Uber:Next Steps 這正好提醒我們,先把「完整物件讀取的正確性與安全降級」做好,再針對確定出現的存取型態處理局部讀取或尖峰併發。
故障時,先犧牲成本與延遲,不要犧牲 bytes 正確性
proxy 進了關鍵路徑,就必須明確回答它自己失效時怎麼辦。Uber 的答案是:若 cache 或 MySQL metadata 失效,手動切到 passthrough,直接把 request 交給 SaaS origin。build 仍能繼續,只是 latency 和 egress 變高;proxy 也會在跨節點、跨資料中心的 active-active 佈署中處理個別 host 故障。Uber:Failure Modes and Mitigations
這個 fallback 的重要性在於它沒有把「cache 壞了」轉成「猜一份舊內容給你」。另外,下載未完整或驗證未完成的內容不能寫進 cache;否則正常重試可能把暫時的網路錯誤變成後續所有 build 都會讀到的損壞資料。
可以把期望順序寫得很直白:
- 快取健康時:低 egress、低傳輸延遲、每次仍驗證。
- 快取或 metadata 壞掉時:提高成本與延遲,直通 origin。
- origin 無法確認內容時:讓讀取失敗並告警,不拿未驗證的 bytes 假裝成功。
這不是高可用的萬靈丹;它只是把故障優先降級到比較容易接受的一側。對 build artifact 而言,通常是成本與時間,而不是內容正確性。
何時值得做,何時別做
不要因為看見大型公司的 proxy 就先開一個 service。若 artifact URL 已經是 content-addressed/不可變、現有 registry 或 CDN 足以處理流量,而且允許的 stale window 明確,先用原生 immutable cache 或標準 CDN 就好。
只有同時出現以下條件時,validation proxy 才值得被列入選項:
- 同一份內容被大量、重複地下載,完整 bytes 的跨網路傳輸是可量到的成本或瓶頸;
- client 需要很小的 stale window,不能只依 TTL;
- origin 支援可用的 validator,並能承受每次驗證的 metadata request;
- 團隊能接受 cache 不可用時的 passthrough 成本,並有監看 304 比率、origin error、cache write failure 和 partial download 的能力。
Uber 公布的逾 99% egress reduction 與 99.99% proxy-layer reliability 是其生產觀察,不能當成別人的預估值。Uber:Results and Impact 但設計原則很可移植:先保留一個權威來源,再把每個最佳化都設計成可驗證、可繞過的加速層。