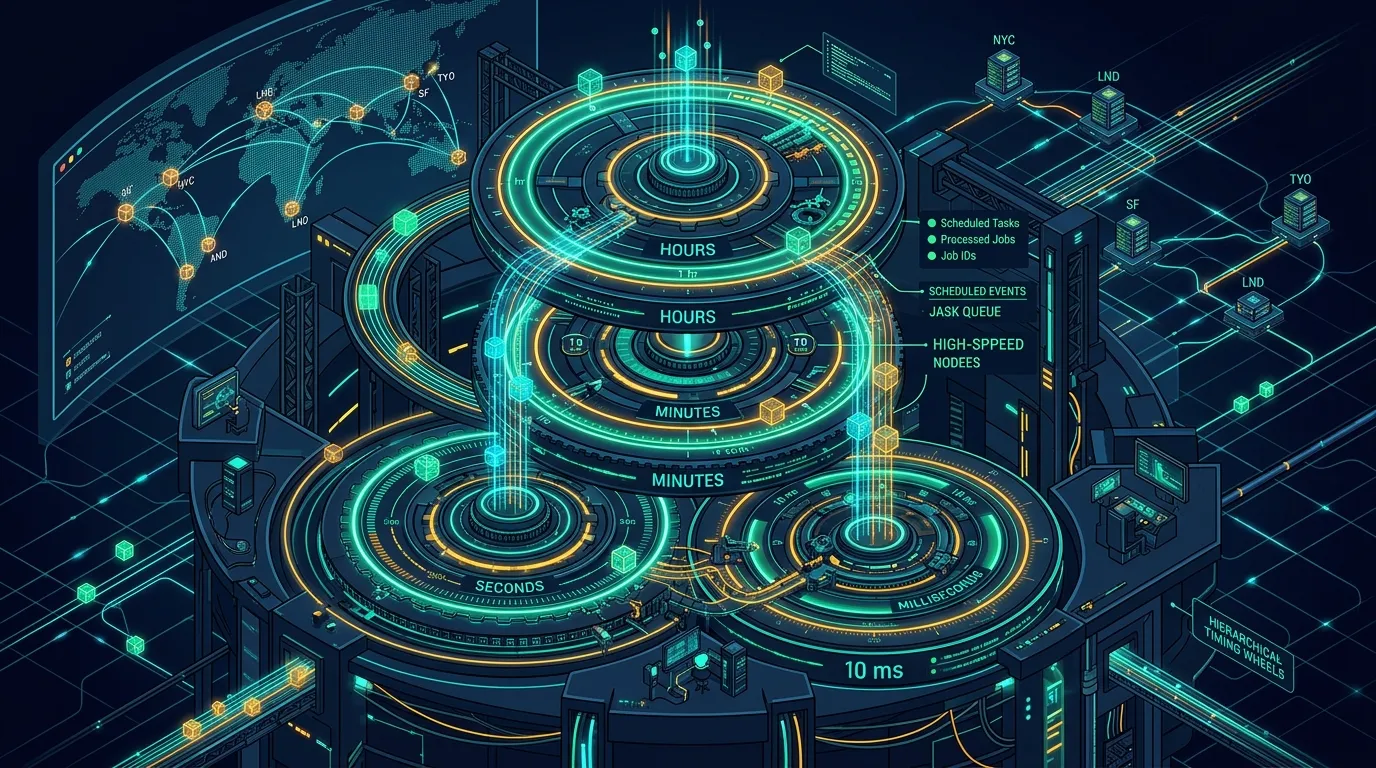
在現代大型網路架構中,「定時與延時任務」無所不在:電商平台在訂單成立 30 分鐘未付款時自動關閉並釋放庫存、外送平台在騎士接單 15 分鐘未取餐時觸發超時警報、遊戲伺服器每隔 100 毫秒同步全地圖玩家狀態,或是使用者預約 3 天後的行事曆推播通知。
當系統面對的是千萬級甚至上億筆同時註冊的定時任務時,傳統的排程思維會立刻遭遇嚴峻的物理極限:
- 輪詢資料庫(Polling DB):每秒掃描
WHERE fire_time <= NOW()會將關聯式資料庫的 I/O 與 CPU 瞬間打爆; - 最小堆(Min-Heap / PriorityQueue):如 Java 的
Timer或 Go 的經典定時器,其插入與刪除操作的時間複雜度為O(log N)。當並發任務達到百萬級別時,頻繁的樹節點調整與記憶體快取不命中(Cache Miss)將引發嚴重的 CPU 顛簸; - Redis Sorted Set(ZSet):雖然提供分散式高可用,但 SkipList 的寫入同樣是
O(log N),且在高頻高精度(毫秒級)場景下,網路 RTT 與單執行緒輪詢吞吐會成為難以跨越的瓶頸。
業界標竿開源專案(如 Apache Kafka 的延時請求緩衝、Netty 的 HashedWheelTimer 以及 Airbnb Chronos / Uber Cadence 的底層排程器)皆不約而同地採用了一種優雅且極致的資料結構——分級時間輪(Hierarchical Timing Wheel)。
本文將帶你從單機單層時間輪的瓶頸出發,剖析多層時間輪如何達成純粹的 O(1) 時間複雜度,並進一步探討如何將這套內核擴展至具備高可用、分區分流與精確防重的全球分散式調度系統。
1. 單層時間輪的演進與「Round 輪數遍歷陷阱」
時間輪(Timing Wheel)的概念最早由 George Varghese 與 Anthony Lauck 於 1987 年的經典論文《Hashed and Hierarchical Timing Wheels》中提出。
其核心哲學是空間換時間:仿造鐘錶的錶盤,將時間劃分成一個固定長度的環形陣列(Circular Array)。每個陣列元素稱為一個 Slot(時間槽),代表一個時間刻度(Tick)。
1.1 單層帶輪數時間輪(Round-based Timing Wheel)
假設我們建立一個長度為 60 的環形陣列,每個 Slot 代表 1 秒,整個輪盤一圈跨度為 60 秒:
- 當前秒針位於
Slot 0; - 若現在註冊一個 15 秒後執行的任務,該任務直接掛入
Slot 15的雙向鏈表; - 若註冊一個 125 秒後執行的任務呢?125 秒超過了一圈(60 秒),我們計算:
- 目標 Slot:
(0 + 125) % 60 = 5 - 輪數(Round):
125 / 60 = 2 - 該任務被掛入
Slot 5,並標記Round = 2。
- 目標 Slot:
秒針每走一格(每秒觸發一次),指針指向當前 Slot。傳統作法是:遍歷該 Slot 鏈表中的所有任務,若 Round == 0 則取出執行;若 Round > 0 則將輪數減 1(Round = Round - 1)。
1.2 致命陷阱:百萬任務下的退化
這種單層 Round 設計在任務分佈稀疏時表現良好,但在大跨度且高密度的生產環境中,會產生嚴重的效能衰退:
2. 分級時間輪(Hierarchical Timing Wheel):時分秒級聯降級
為了解決單層時間輪在長跨度任務下的遍歷退化,Kafka 與現代高性能網路庫借鑑了實體機械手錶的齒輪進位機制,設計了分級時間輪(Hierarchical Timing Wheel)。
第 3 層:時輪(Hour Wheel)
刻度與跨度:每格 1 小時,共 24 格(覆蓋 24 小時)。
運作特性:長延時任務直接插入對應時槽(如 2h),插入複雜度恆為 O(1),無須單層時間輪的 Round 輪數計數。
第 2 層:分輪(Minute Wheel)
刻度與跨度:每格 1 分鐘,共 60 格(覆蓋 1 小時)。
運作特性:任務自時輪拔出後,按剩餘分鐘數重新掛載(如 15m 格)。高層時間輪極慢的轉動頻率大幅節省 CPU 資源。
第 1 層:秒輪(Second Wheel)
刻度與跨度:每格 1 秒,共 60 格(毫秒級高精度)。
運作特性:秒針到達目標刻度(如 32s),即刻彈出任務送入執行佇列。搭配 Kafka DelayQueue 僅將有任務的 Bucket 入堆,杜絕全無任務時的空轉中斷。
2.1 齒輪進位與階層劃分
分級時間輪將時間輪拆分為多個不同解析度的層級,下一層的時間跨度(Interval)正好等於上一層單一 Slot 的刻度長度(Tick Duration):
| 時間輪層級 | 刻度大小(Tick Duration) | 槽位總數(Slots) | 總覆蓋時間跨度(Wheel Span) | 職責與對應任務 |
|---|---|---|---|---|
| 第 1 層:秒輪(Second Wheel) | 1 秒 | 60 | 60 秒(1 分鐘) | 毫秒/秒級即將觸發的極短延時任務 |
| 第 2 層:分輪(Minute Wheel) | 60 秒(1 分鐘) | 60 | 3600 秒(1 小時) | 1 小時以內的中期任務 |
| 第 3 層:時輪(Hour Wheel) | 3600 秒(1 小時) | 24 | 86400 秒(1 天) | 24 小時以內的長週期任務 |
| 第 4 層:天輪(Day Wheel) | 1 天 | 30 | 30 天(1 個月) | 月度維度的大跨度任務 |
在分級時間輪中,任務永遠不需要標記 Round 輪數!每個任務根據其剩餘延遲時間,精確且唯一地掛載到能容納它的那一層時間輪的某一個 Slot 中:
- 一個 30 秒後執行的任務,直接掛在秒輪的第 30 格;
- 一個 15 分鐘後執行的任務,秒輪容納不下(跨度僅 60 秒),它被直接推進並掛入分輪的第 15 格;
- 一個 5 小時後執行的任務,分輪也容納不下,直接掛入時輪的第 5 格。
無論跨度多長,任務插入(Insert)的時間複雜度恆定為 O(1)。
2.2 降級機制(Cascade / Demotion)
分級時間輪最精妙的核心在於**「高層向低層的級聯降級(Cascade)」**:
- 高層時間輪(如時輪)的指針轉動頻率極低(每小時前進一格),完全沒有高頻空轉的 CPU 浪費。
- 當「時輪」的指針前進一格(例如從 0h 移動到 1h)時,該 Slot 鏈表中的所有任務已經進入了「未來 1 小時之內」的範圍。
- 調度內核將這些任務從時輪中拔出,重新計算剩餘時間(
remaining_delay = target_time - current_time),並將它們**降級(Cascade)**下放到「分輪」的對應 Slot 中! - 同理,當分輪的指針每分鐘前進一格時,該 Slot 內進入「最後 60 秒」的任務會被拔出並再次降級下放到「秒輪」。
- 當秒輪的指針走到指定 Slot 時,所有任務此時已經到達觸發時間點,調度器立即彈出任務並送入執行執行緒池。
2.3 Kafka 的神來之筆:結合 DelayQueue 避免空轉推進
即使用了分級時間輪,如果沒有任務到期,最底層的秒輪或毫秒輪是否依然需要每毫秒觸發一次執行緒喚醒?
如果大量時間段根本沒有任何任務,每毫秒空轉依然會造成不可忽視的 Context Switch 開銷。
Apache Kafka 提出了一種極其出色的混合設計:分級時間輪 + Java DelayQueue(最小堆)。
- Kafka 並不為每一個任務維護 DelayQueue,因為百萬個任務進 DelayQueue 會引發
O(log N)顛簸; - 相反地,Kafka 只把**包含任務的 Slot(Bucket)**放入 DelayQueue!
- 由於一個時間輪的 Bucket 數量非常有限(例如 60 個),DelayQueue 的元素上限被嚴格限制在幾十個以內,插入與彈出的代價近乎於
O(1); - 工作執行緒(ExpiredOperationReaper)呼叫
DelayQueue.poll(timeout)阻塞等待最近一個到期的 Bucket。一旦被喚醒,就代表該 Bucket 已經準時到期,指針瞬間「快進」推進到該時間刻度,並迅速將 Bucket 中的所有任務執行或降級。這徹底杜絕了毫秒級定時器的無效空轉!
3. 從單機走向全球:分散式定時調度架構實戰
單機內核的分級時間輪已經將記憶體調度演算法推向極致,但在大型微服務體系中,我們面臨的是另一個維度的挑戰:節點當機任務不能丟失、單機記憶體容納不下億級任務、以及多節點協同下的防重複執行。
生產級分散式調度系統必須透過**調度協調中心(Coordinators)與執行工作節點(Workers)**的職責分離來建構:
1. 協調控制面(Coordinator Ring)
選主與分片:透過 Etcd / Raft 達成一致性選主,建立 1024 虛擬槽位雜湊環。
容災感知:當節點失聯時,心跳機制即時觸發租約撤銷與分區重平衡。
2. 分區儲存與時間輪分層(Cold / Hot)
冷資料儲存:大於 1 小時的延時任務持久化於 TiDB / MySQL 狀態表。
熱資料預加載:即將到期的任務載入本機分級時間輪;到期後推入 Kafka 提供原生背壓保護。
3. Worker 執行叢集與 CAS 防重
Pull 模式消費:Worker 依據自身 CPU / 記憶體負載自主拉取,避免雪崩。
CAS 狀態機:執行前執行 UPDATE ... SET status='RUNNING' WHERE status='SCHEDULED',徹底防範重複調度。
3.1 職責分離與一致性雜湊分片(Consistent Hash Sharding)
若讓所有節點都去爭搶同一個資料庫或全域定時輪,鎖衝突與網路開銷將會摧毀吞吐量。
現代分散式調度器採用「分區分流」架構:
- 協調叢集(Coordinator Ring):
- 透過 Etcd 或 Consul 維護一個協調者節點叢集,節點間利用 Raft 協定維持心跳並構建全域一致性雜湊環(Consistent Hash Ring);
- 虛擬槽位(Hash Slots,例如 1024 個 Slot)均勻分攤給在線的 Coordinator 節點。
- 任務分片與時間分層:
- 當業務方透過 API 註冊一個延時任務時,系統計算
hash(task_id) % 1024,將任務指派給負責該 Slot 的 Coordinator; - 冷熱分離存儲:未來大於 1 小時的長延時任務僅持久化於 MySQL / TiDB / Cassandra 中;只有即將在未來 1 小時內到期的熱任務,才會被非同步預加載(Prefetch)進 Coordinator 的本機分級時間輪記憶體中。
- 當業務方透過 API 註冊一個延時任務時,系統計算
-- 分散式任務狀態機持久化表結構
CREATE TABLE distributed_scheduled_tasks (
    task_id VARCHAR(64) PRIMARY KEY,
    shard_id INT NOT NULL,              -- 一致性雜湊槽位 (0 ~ 1023)
    target_fire_time BIGINT NOT NULL,   -- 預計觸發毫秒時間戳
    status VARCHAR(20) NOT NULL,        -- PENDING, SCHEDULED, RUNNING, SUCCESS, FAILED
    version INT NOT NULL DEFAULT 0,     -- CAS 樂觀鎖版本號
    retry_count INT NOT NULL DEFAULT 0,
    payload JSON NOT NULL,
    INDEX idx_shard_fire_time (shard_id, target_fire_time, status)
);
3.2 防重防漏保證:At-least-once 語義與 CAS 狀態機
在分散式環境下,面對網路分區(Network Partition)或 Coordinator 節點異常崩潰,「保證不漏調度」意味著我們必須接受 At-least-once(至少投遞一次) 的基本假設。
為了在 At-least-once 之下保證業務執行的精確一次(Effectively Exactly-once),系統依賴兩道防禦屏障:
屏障 1:CAS 樂觀鎖搶佔執行權(State Transition)
當時間輪觸發任務並分發給 Worker 執行節點時,多個節點(或重試節點)可能同時收到通知。Worker 在真正執行業務邏輯前,必須先執行原子 CAS 更新:
-- 搶佔任務執行權
UPDATE distributed_scheduled_tasks
SET status = 'RUNNING', version = version + 1, updated_at = NOW()
WHERE task_id = :taskId
  AND status = 'SCHEDULED'
  AND version = :expectedVersion;
只有資料庫影響行數(Affected Rows)等於 1 的 Worker 節點,才擁有合法的執行租約(Lease)。
屏障 2:Worker 端分散式互斥鎖與業務冪等鍵
在超高併發或毫秒級頻率下,頻繁更新資料庫會成為瓶頸。此時可在 Worker 端引入 Redis 分散式鎖作為第一道快篩:
// Worker 節點執行前的冪等鎖防禦
async function executeScheduledTask(task: ScheduledTask): Promise<void> {
  const lockKey = `lock:task:${task.id}:${task.targetFireTime}`;
  // 設置略大於任務執行超時時間的 TTL
  const acquired = await redis.set(
    lockKey,
    workerInstanceId,
    "PX",
    30000,
    "NX",
  );

  if (!acquired) {
    logger.warn(`Task ${task.id} already claimed by another worker. Skipping.`);
    return;
  }

  try {
    // 呼叫下游業務微服務(業務本身依據 taskId 具備冪等性保證)
    await invokeBusinessHandler(task.payload);

    // 標記任務執行成功
    await markTaskSuccess(task.id);
  } catch (error) {
    logger.error(`Task execution failed: ${error}`);
    await handleTaskFailureWithBackoff(task, error);
  } finally {
    // 釋放分散式鎖或等待自動過期
    await releaseRedisLock(lockKey, workerInstanceId);
  }
}
4. 調度模式決策:Worker Pull 還是 Coordinator Push?
當任務在時間輪中到期後,調度系統有兩種方式將任務交給 Worker 叢集執行:
| 維度對比 | Coordinator Push(主動推送模式) | Worker Pull(基於消息隊列拉取模式) |
|---|---|---|
| 運作機制 | Coordinator 透過 gRPC / HTTP 直接呼叫 Worker 實例 | Coordinator 將到期事件推入 Kafka / Pulsar,Worker 叢集以 Consumer Group 自主拉取 |
| 延遲表現 | 極致低延遲(< 5ms),無中間中介軟體轉發 | 受限於消息中介軟體的寫入與 Pull 輪詢間隔(通常 10~50ms) |
| 背壓(Backpressure)能力 | 脆弱。若 Worker 算力飽和,推送易導致 Worker 記憶體 OOM 或連線堆積 | 極強原生背壓。Worker 依據自身 CPU/記憶體負載自適應拉取,絕不會被打垮 |
| 節點動態擴縮容 | Coordinator 需維護完整的 Worker 服務發現與健康檢查清單 | 完全解耦。Worker 叢集可任意水平擴展,無須通知 Coordinator |
| 適用場景 | 內部即時高精度定時器(如遊戲伺服器 Tick、即時超時中斷) | 企業級海量非同步排程(如訂單關閉、計費報表、大宗通知發送) |
5. 工程復盤與邊界調優
在將分級時間輪與分散式調度器部署上線前,以下三個關鍵邊界問題必須納入監控與防禦策略:
5.1 伺服器時間跳變(NTP Jump / Leap Second)
時間輪依賴時鐘推進。如果伺服器依賴 System.currentTimeMillis(),當系統遭遇 NTP 伺服器校時跳躍(向前跳或向後回退數秒)時,時間輪會發生嚴重災難:
- 時鐘回退:秒針倒退或停滯,導致本該到期的任務延遲觸發;
- 時鐘突跳:時間輪指針瞬間跳躍多格,導致中間跨度的任務在一瞬間全部湧出,引發下游服務雪崩。
解法:在單機時間輪內核中,永遠使用單調時鐘(Monotonic Clock)(如 Java 的 System.nanoTime() 或 Go 的 time.Now() 單調時鐘部分)。單調時鐘保證時間永遠往前遞增且不受 NTP 校時回撥影響。
5.2 記憶體容量估算與 OOM 防護
假設系統在線任務有 1,000 萬筆:
- 若全部常駐記憶體,以每個 Task 節點物件約 128 Bytes 計算:
10,000,000 × 128 Bytes ≈ 1.28 GB - 記憶體消耗看似可控,但若任務附加了大量 JSON Payload,記憶體會暴增至數十 GB,並引發頻繁的垃圾回收(GC Stop-the-World),進而破壞時間輪的毫秒級精度。
解法:記憶體中的時間輪只儲存最輕量化的元資料:TaskNode { taskId: u64, fireTime: u64, shardId: u16 }(每節點僅 24 Bytes)。完整的業務 Payload 保留在資料庫或 Object Storage 中,直到任務觸發執行時再依 taskId 讀取或透過指針延遲解碼。
6. 總結與下一步落地方案
回顧時間調度技術的演進脈絡:
- 單機階段:從
PriorityQueue的O(log N)樹調整,演進至分級時間輪的O(1)進位與級聯降級,透過空間結構徹底化解時間複雜度難題; - 分散式階段:透過一致性雜湊進行分區槽位分配,結合 CAS 樂觀狀態機與 At-least-once 語義,讓調度系統具備了水平擴展與容災復原的能力。
如果你正在為團隊規劃或改造延時調度架構,建議採取以下落地路徑:
- 第一步(盤點維度):統計全站延時任務的精度需求(秒級 vs. 分鐘級)與資料總量。若在百萬級以下且延遲容忍在 1 秒內,優先使用 Redis ZSet 即可快速落地;
- 第二步(引入分級時間輪):當任務規模達到千萬級且對調度精度要求極高時,直接引入 Netty
HashedWheelTimer或 Kafka TimingWheel 內核,避免自行發明帶 Round 的單層時間輪輪詢輪子; - 第三步(完善背壓鏈路):將時間輪的到期觸發事件對接既有的訊息中介軟體(Kafka / RocketMQ),讓 Worker 節點透過 Pull 模式自主消費,建構高彈性且具備背壓防禦的企業級調度平台。