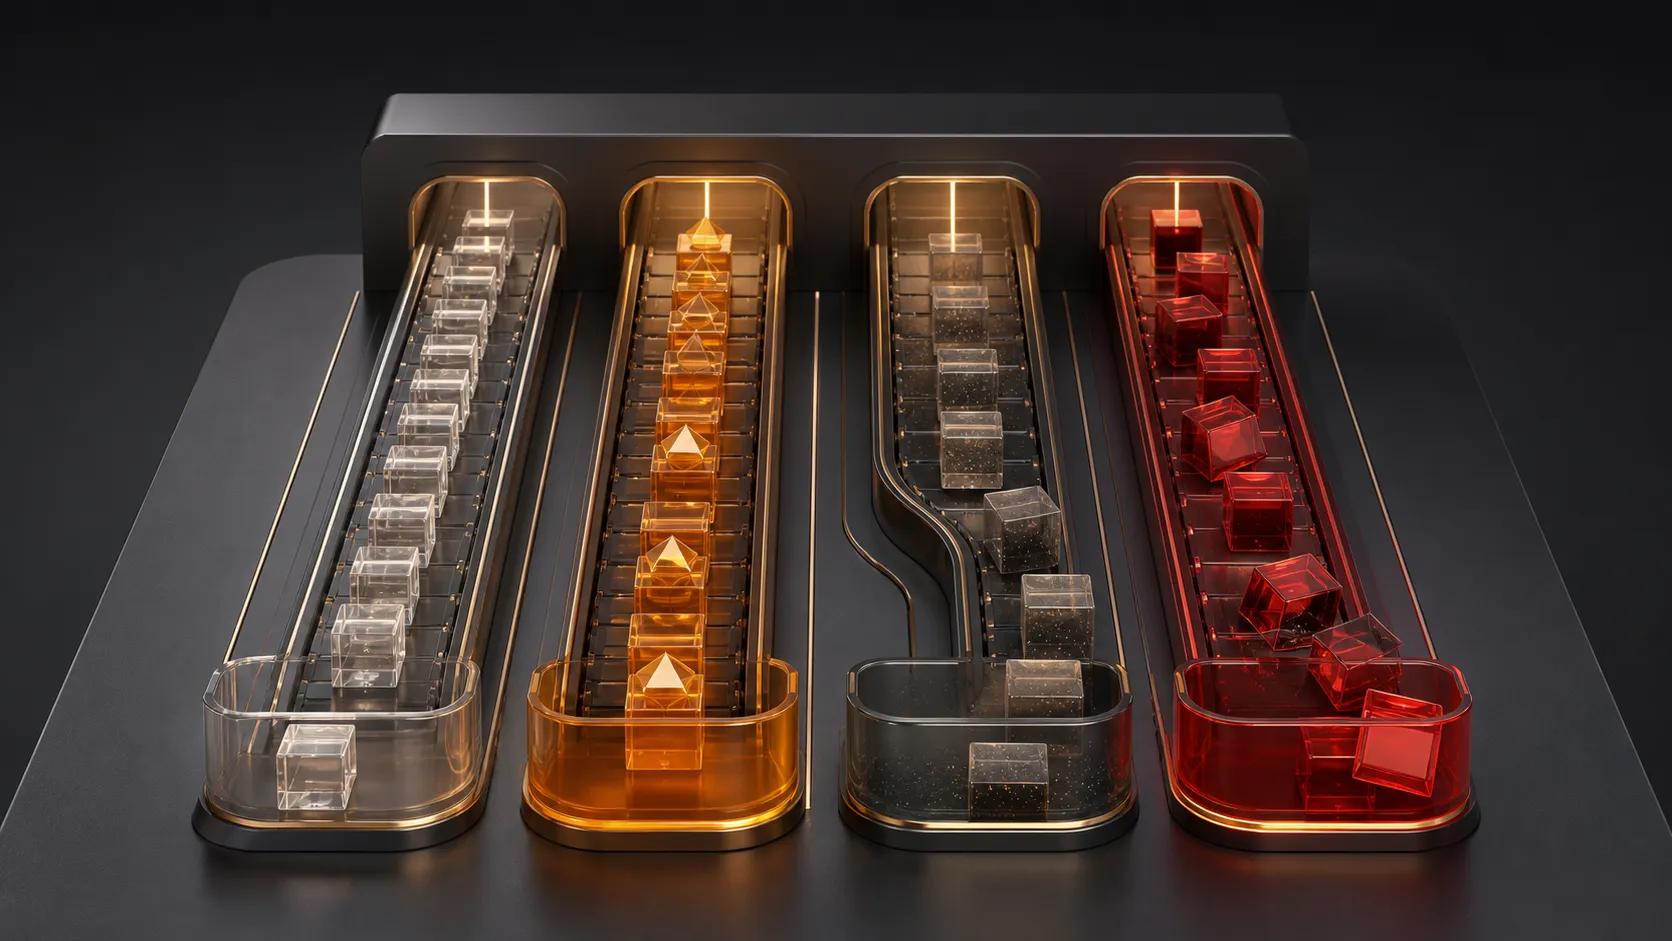
在設計事件驅動系統與分散式背景任務排程時,消息隊列絕不僅僅是「先進先出(FIFO)」的簡單管道。
不同業務場景對訊息的處理時序與生命週期有著截然不同的嚴苛要求:
- 金融交易與狀態機變更要求嚴格順序(Strict Ordering);
- VIP 客戶與緊急警報需要優先插隊處理(Priority Processing);
- 訂單超時 30 分鐘自動取消、定時推播需要高精度延時調度(Delay Scheduling);
- 格式錯誤引發消費者崩潰的「毒丸消息(Poison Pill)」需要被安全隔離至死信隊列(Dead Letter Queue, DLQ)。
本文將深度剖析這四大核心隊列模式的底層資料結構、時間複雜度與生產級實踐架構。
1. 順序隊列(FIFO Queue):全局順序 vs. 分區順序
- 全局嚴格順序(Global FIFO):整個隊列只有 1 個分區與 1 個消費者實例。一旦出現慢任務,全站阻塞。
- 分區順序(Partitioned FIFO):在真實世界中,跨使用者的事件順序往往無關緊要(User A 的付款不需要排在 User B 的前面)。以
user_id作為 Sharding Key / MessageGroupId,既能保證單一業務實體內部的嚴格時序,又能透過增加分區實現極致的平行處理擴展!
2. 優先級隊列(Priority Queue)與防飢餓機制
當系統出現突發堆積時,付費 VIP 使用者的請求或系統 P0 級故障警報必須優先於行銷郵件被消費。
2.1 實作架構
- 二叉最大堆(Binary Max-Heap)/ 跳躍表:在記憶體中維護優先級堆,時間複雜度為
O(log N)。 - 多優先級物理桶分流(Multi-bucket Routing - 推薦):建立 3 個獨立的物理佇列(
queue_high,queue_med,queue_low),消費者採用加權輪詢(例如以 7:2:1 的比例從三個佇列拉取任務)。
2.2 防飢餓機制(Starvation Prevention / Aging)
若高優先級任務持續以 100% 頻率湧入,低優先級任務將永久無法被執行(飢餓效應)。
- 動態老化演算法(Aging Algorithm):低優先級任務在佇列中每等待超過 1 分鐘,其優先級評分自動提高一階,確保所有任務最終均能在有限時間內獲得處理。
3. 延時隊列(Delay Queue):三大底層架構解析
延時隊列用於「在未來的某個特定時間點執行任務」(如:訂單 30 分鐘未支付自動關閉、用戶註冊 7 天後發送回訪通知)。
| 實現方案 | 底層技術 | 時間精度 | 優缺點 |
|---|---|---|---|
| 1. 時間輪 (TimingWheel) | 環形陣列 + 雙向鏈表 | 毫秒級高精度 | 記憶體開銷低,O(1) |
| 2. Redis Sorted Set | SkipList + Dict | 毫秒級 | 分散式原生,高可用 |
| 3. RabbitMQ 死信 TTL | Message TTL + DLX | 粗粒度 (隊頭阻塞) | 存在隊頭非均勻過期坑 |
3.1 時間輪演算法(Hashed TimingWheel)
如同鐘錶的秒針每秒前進一格,時間輪將時間劃分為多個圓形 Slot(例如 60 個格子的環形陣列,每個 Slot 代表 1 秒):
- 添加任務:計算目標 Slot 與輪數(
Round = delay / 60),將任務掛入對應 Slot 的雙向鏈表,時間複雜度為O(1)! - 執行任務:指針每走一格,檢查當前 Slot 的鏈表,將
Round == 0的任務取出執行,其餘任務Round -= 1。
3.2 Redis Sorted Set(ZSet)延時佇列實作
- 將任務 Payload 作為 Value,將 觸發時間戳(
unix_timestamp)作為 Score 存入 ZSet:ZADD delay_queue <target_timestamp> <task_payload> - 消費者定時輪詢(或透過 Redis Lua 腳本):
ZRANGEBYSCORE delay_queue 0 <current_timestamp> LIMIT 0 10並使用ZREM原子取出並刪除到期任務。
4. 毒丸防禦與死信隊列(Dead Letter Queue, DLQ)
在消費訊息時,若某條訊息因為 JSON 格式損壞、程式 NullPointer 異常或除以零,導致消費者在處理該訊息時反覆拋出異常並 Crash。
在重試機制下,該訊息會被反覆重新排入隊頭,導致所有消費者相繼崩潰,使整個隊列完全卡死——這就是可怕的毒丸消息(Poison Pill)。
4.1 生產級死信自動化處理管線
- 重試計數器(Retry Counter):在 Message Header 中維護
x-retry-count。 - 熔斷隔離至 DLQ:當重試次數超過閾值(如 3~5 次)時,停止重新排隊,直接將該訊息路由至死信隊列。
- 主隊列暢通無阻:主業務隊列繼續順暢消費後續正常訊息,消除毒丸阻塞。
- 人工審計與修復重播(Replay):工程師修復程式代碼後,透過死信管理工具將 DLQ 中的歷史消息重新注入主隊列完成補償。