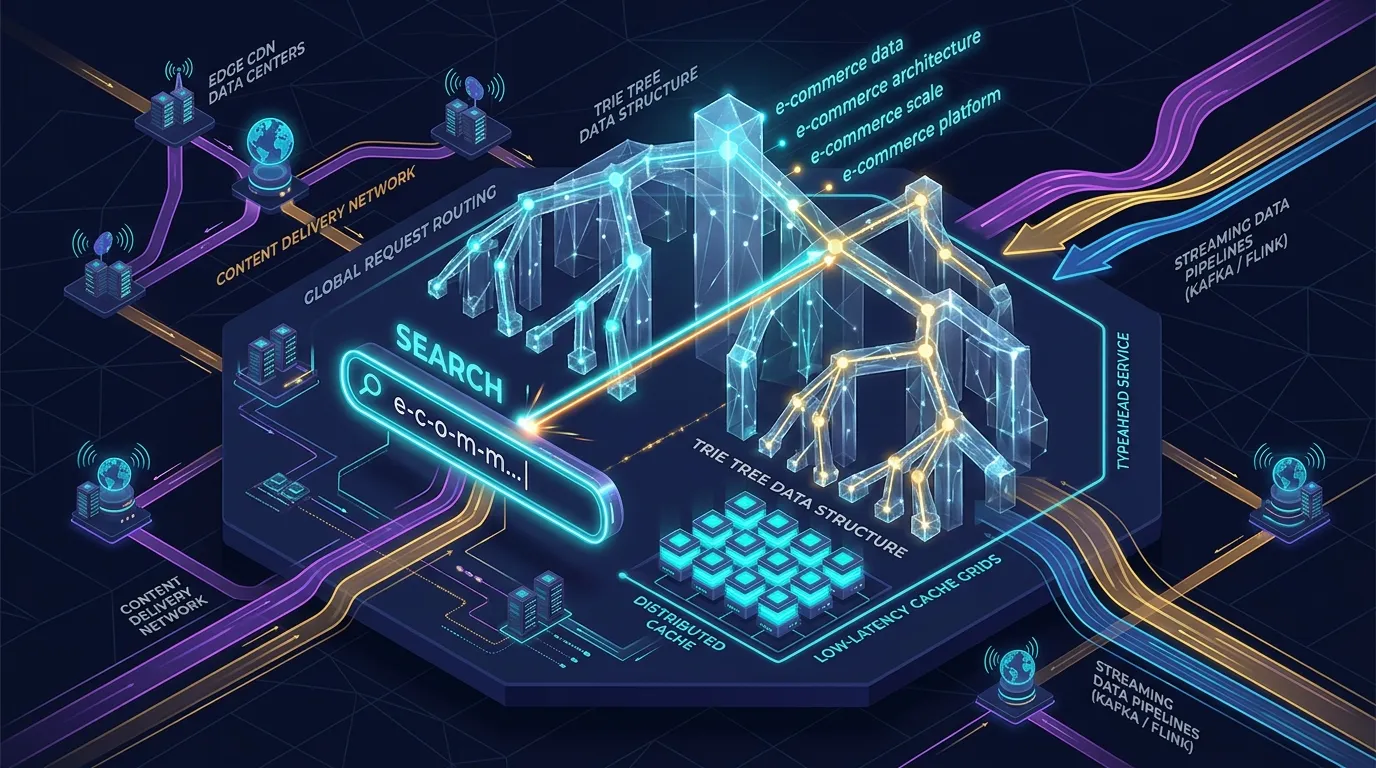
當你在 Google、Amazon 或 YouTube 搜尋框敲下一個字母 s 時,下拉選單在不到 30 毫秒內便即時彈出 spotify、speed test 與 steam;當你接著敲下 y 變成 sy 時,建議列表瞬間變更為 system design、synonym 與 symptom checker。
這項功能在軟體工程中被稱為 即時自動補全(Typeahead / Autocomplete)。
表面上看,它只是一個「前綴字串比對」的簡單功能;但在系統架構維度,它卻隱藏著極其嚴苛的高併發挑戰:
- 請求頻率呈指數級放大:傳統搜尋是使用者打完字按下 Enter 後才發起 1 次請求;自動補全則是每敲一個按鍵就觸發一次網路呼叫。一個平均長度為 6 個字母的單字,意味著後端要承受 6 倍以上的查詢流量;
- 極致低延遲的要求(P99 < 50ms):自動補全必須跟上使用者的打字速度。如果延遲超過 100 毫秒,建議詞就會在使用者已經敲下後續字母時才跳出來,形成嚴重的 UI 閃爍與糟糕的互動體驗;
- 海量詞庫與熱門權重排序(Top-K):在數億個搜尋詞中,系統不能只返回「所有匹配的前綴」,而是必須依據全網實時點擊熱度,在常數時間內返回排序最高的前 5 到 10 筆結果。
本文將帶你從演算法內核出發,推導為什麼關聯式資料庫 LIKE 'sy%' 與常規字典樹會徹底崩潰,並逐步構建出支撐全球數十萬 QPS 的生產級 Typeahead 架構。
1. 為什麼關聯式資料庫與全文檢索引擎難以勝任?
很多工程師在初次面對自動補全需求時,最直覺的想法是使用既有的資料庫:
1.1 關聯式資料庫 LIKE 'abc%'
SELECT query, search_count
FROM search_keywords
WHERE query LIKE 'sy%'
ORDER BY search_count DESC
LIMIT 5;
雖然 query LIKE 'sy%' 可以走 B+ Tree 索引的最左匹配原則,但在海量高併發場景下存在致命缺陷:
- 磁碟 I/O 頻頸:每次按鍵都觸發一次 Index Range Scan + 回表查詢 + 記憶體排序(FileSort);
- 併發上限極低:單台 MySQL 即使有大量記憶體快取,也難以支撐超過 5,000 QPS 的模糊查詢,面對 10 萬+ QPS 的全球輸入流量會瞬間引發連線池耗盡與 CPU 100%。
1.2 Elasticsearch 前綴查詢(Prefix Query / Completion Suggester)
Elasticsearch 的 Completion Suggester 內部採用了有限狀態轉換器(FST, Finite State Transducer),在單機中小型詞庫表現極佳。
但在十億級別詞條與數十萬即時熱搜動態打分的場景下,FST 的記憶體開銷較高,且其分片跨節點查詢(Scatter-Gather)的網路 RTT 難以穩定壓制在 10 毫秒以內。
為了追求極致的 記憶體定址速度 與 確定性時間複雜度,現代搜尋巨頭的核心均回歸至一種經典資料結構——字典樹(Trie Tree)。
2. 演算法內核:從常規 Trie 到 Top-K 預存字典樹
Trie(源自 Retrieval,又稱前綴樹或字典樹)是一種專門處理字串快速檢索的樹狀資料結構。
2.1 常規 Trie 的遍歷瓶頸:$O(p + n)$ 陷阱
在常規的 Trie 樹中:
- 每個節點代表一個字元;
- 樹根為空前綴;
- 從根節點往下延伸到某個節點,沿途路徑組成的字元即為前綴字串。
若要查詢前綴為 sy 的熱門詞:
- 先從根節點向下定址到前綴的末端節點(耗時取決於前綴長度
p,即 2 次指標移動); - 致命瓶頸:接著必須遍歷該節點底下的整棵子樹(共
n個節點),收集所有可能的完整詞彙,並透過堆積(Heap)選出前 5 大熱門詞。
2.2 破局之道:Top-K 字典樹(空間換時間)
為了解決運行時遍歷子樹的效能災難,現代系統採用**「空間換時間」**的架構哲學:在 Trie 樹的每一個前綴節點上,直接預先計算並快取該節點子樹中權重最高的前 K 筆關鍵詞。
全域根節點(Root Node)
前綴:空字串 ""。
作用:使用者游標點進搜尋框尚未鍵入任何字母時,即刻展示全站 Top 3 熱搜(youtube、google、amazon)。
前綴「s」節點
指針尋址:O(1) 直達 's' 節點。
預存結果:spotify (9.8M)、speed test (6.2M)、steam (5.4M)。
效能效益:完全不必遍歷 's' 底下數百萬個字彙,直接回傳預存清單。
目標前綴「sy」節點
查詢時間:O(p) = O(2)。兩次指標跳轉完成檢索,延遲小於 0.5ms。
返回 Top-K 推薦:
- 1. system design (8,920,000 熱度)
- 2. synonym (4,150,000 熱度)
- 3. symptom checker (2,780,000 熱度)
- 4. syntax error (1,940,000 熱度)
💡 空間換時間代價:1000 萬詞庫僅約 3.12 GB 記憶體,以極低成本換取百萬 QPS 吞吐。
如上圖所示,Top-K 字典樹在不同前綴節點的檢索行為如下:
| 前綴路徑 | 命中節點 | 內部預存之 Top-K 結果 | 尋址與檢索代價 | 傳統 Trie 相比之效益 |
|---|---|---|---|---|
""(空字串) | Root | youtube (98M)、google (85M)、amazon (72M) | O(1) 直讀 | 搜尋框聚焦即刻展示全站熱搜,零資料庫查詢 |
"s" | ‘s’ | spotify (9.8M)、speed test (6.2M)、steam (5.4M) | O(1) 指針跳轉 | 省去遍歷 ‘s’ 底下數百萬個單字的巨大開銷 |
"sy" | ‘sy’ | system design (8.9M)、synonym (4.1M)、symptom checker (2.7M) | O(p) = O(2) 指針跳轉 | P99 延遲 < 0.5ms,徹底消除運行時即時排序 |
查詢複雜度徹底降為 O(p)(p 為前綴長度)!因為不需要任何額外的子節點遍歷或運行時排序,調度器只需沿著前綴字元走 p 步,直接讀取目標節點所儲存的清單即可。
空間代價估算(Capacity Estimation)
很多工程師會擔心:每個節點都存 Top-K,記憶體會不會爆炸?
我們透過容量估算公式進行嚴謹驗算:
| 評估項目 | 估算參數 | 佔用記憶體計算 | 備註說明 |
|---|---|---|---|
| 詞庫總量 | 1,000 萬(10M)有效詞彙 | - | 去除極冷門長尾詞後的活躍詞庫 |
| Trie 總節點數 | 平均詞長 6 字元 ➔ 約 3,000 萬節點 | - | 共用前綴壓縮後的總節點數量 |
| Top-K 快取指標 | 每個節點預存 5 筆詞彙 ID / 指標 | 5 × 8 Bytes = 40 Bytes | 僅存輕量 ID,不存重複字串本體 |
| 節點基礎結構 | 子節點指標陣列與元資料 | 約 64 Bytes | 指針壓縮與緊湊佈局 |
| 單節點總大小 | 40 Bytes + 64 Bytes | 約 104 Bytes | 輕量化節點設計 |
| 全站總記憶體 | 30,000,000 × 104 Bytes | 約 3.12 GB | 單台平價伺服器即可完整常駐記憶體 |
3. 全球高併發端到端拓撲:多級快取與前綴分片
單台機器上的 Top-K Trie 雖然神速,但當面對每秒十萬次請求、多語言輸入以及熱門搜尋詞每分每秒動態變化的現實時,單機架構顯然無法獨立支撐。
下圖展示了支撐大規模流量的端到端系統拓撲:
1. 客戶端與邊緣快取層
客戶端防抖(Debounce):50ms 延遲發送,避免每次按鍵都發起網路調用。
邊緣 CDN 快取:熱門的一碼/二碼前綴(如 "g", "go", "a")快取在 CDN 邊緣,抵擋 80% 全球高頻請求。
2. 前綴分片 Trie 服務叢集
前綴二級分片:按首字母與次級字元分發至特定 Shard,熱點字母(如 "s")進一步拆分為獨立子 Shard。
極致查詢性能:Top-K 字典樹常駐記憶體,單機單次查詢耗時小於 5 毫秒。
3. 串流動態重打分與雙緩衝切換
Kafka + Flink:實時統計關鍵字點擊頻率,並引入時間半衰期衰減避免歷史詞霸榜。
雙緩衝無鎖替換:離線建立新 Trie 樹後透過原子指標切換(Atomic Swap),保證讀取無中斷。
3.1 客戶端與邊緣 CDN 防線(消滅 80% 流量)
在高併發系統中,最好的請求就是「根本不打到後端」的請求。
- 客戶端防抖(Debounce):
- 使用者在連續敲擊鍵盤時(例如打出
system耗時 0.5 秒),前端若每個按鍵立即發送請求,會發出 6 次網路調用; - 透過設置 50ms 的防抖定時器,只有當使用者打字停頓超過 50 毫秒時才真正發出 API 請求。光是這個微小的防禦,就能在源頭過濾掉近 40% 的瞬時無效請求。
- 使用者在連續敲擊鍵盤時(例如打出
- 瀏覽器記憶體快取(In-Memory Cache):
- 當使用者打錯字按下 Backspace(例如從
syst刪回sys)時,前端直接從瀏覽器本地 Map 中讀取先前已緩存的結果,無須重新走網路。
- 當使用者打錯字按下 Backspace(例如從
- 邊緣 CDN 快取(Edge Caching):
- 統計顯示,搜尋流量存在強烈的帕累托法則(80/20 法則):使用者輸入的前 1 到 2 個字母(如
g,go,a,w),其推薦結果在全網高度一致且極為熱門; - 將這些超熱門短前綴的 JSON 結果直接快取在 Cloudflare / CloudFront 邊緣節點(設定 TTL 5
10 分鐘)。這讓全球 80% 的初期請求直接在使用者附近的邊緣機房命中返回,延遲僅需 515ms!
- 統計顯示,搜尋流量存在強烈的帕累托法則(80/20 法則):使用者輸入的前 1 到 2 個字母(如
3.2 前綴分片(Prefix Sharding)與熱點傾斜防禦
當請求穿透邊緣抵達後端時,Trie 叢集必須進行分片以實現水平擴展。
傳統首字母分片的陷阱
如果簡單地按照首字母分成 26 個 Shard(Shard A 存 a 開頭、Shard S 存 s 開頭):
- 以字母
s,c,t開頭的字詞與搜尋頻率極高; - 以字母
x,z,q開頭的詞極度冷門; - 這將引發嚴重的資料傾斜(Data Skew)與 CPU 熱點傾斜,Shard S 已經被打死,Shard Z 卻處於閒置狀態。
生產級解決方案:二級動態分片(Hierarchical Prefix Sharding)
現代架構採用「兩級前綴映射 + 一致性雜湊」:
- 冷門字母維持單一分片;
- 對於高頻熱門字母(如
s),系統將其進一步細拆為二級前綴:Shard S1: 負責sa ~ seShard S2: 負責sf ~ slShard S3: 負責sm ~ ssShard S4: 負責st ~ sz
- 透過 API Gateway 的路由表(Routing Table),精準將前綴導向對應的微服務實例,達成叢集間負載的完全均衡。
4. 串流動態打分與雙緩衝(Double Buffering)無鎖替換
搜尋關鍵字的熱度是動態變化的(突發新聞、明星八卦、節慶促銷)。我們如何在不停機且不影響讀取效能的前提下,即時更新 Trie 節點上的 Top-K 評分?
4.1 點擊日誌串流與時間半衰期衰減(Time-Decay Scoring)
若單純依據歷史搜尋總次數,老牌熱門詞將永遠霸佔榜首,新興突發事件永遠無法出現在推薦列表中。
系統採用 Apache Kafka + Apache Flink 建構近即時的動態評分管線:
- 日誌匯總:使用者每一次完成搜尋或點擊補全詞的行為,被非同步寫入 Kafka 佇列;
- 滑動視窗聚合(Sliding Window):Flink 每隔 5 分鐘統計一次關鍵詞的點擊增量;
- 時間衰減評分公式(Exponential Decay):
Score = Score_old × e^(-λ × Δt) + Weight_new × Count_new透過指數衰減常數λ,讓過去的搜尋熱度隨時間推移自然稀釋,確保當下的突發熱點能在數分鐘內迅速上升至 Top 5。
4.2 雙緩衝無鎖替換(Atomic Pointer Swap)
在記憶體中的 Trie 樹若在大量讀取請求的同時進行節點寫入或排序,會面臨高昂的讀寫鎖(RWLock)競爭開銷,引發嚴重的讀取阻塞。
業界標竿做法是採用雙緩衝無鎖切換(Double Buffering):
// 搜尋服務內部持有的原子指針封裝
class TypeaheadTrieService {
  // 當前正在提供服務的唯讀 Trie 實例(Atomic Pointer)
  private activeTrie: TrieRoot;

  constructor(initialTrie: TrieRoot) {
    this.activeTrie = initialTrie;
  }

  // 讀取請求:純記憶體指標尋址,無任何鎖競爭,P99 < 1ms
  public queryTopK(prefix: string): string[] {
    return this.activeTrie.lookup(prefix);
  }

  // 非同步更新:背景獨立構建完整的新樹,建好後瞬間原子切換
  public reloadNewTrie(newTrieSnapshot: TrieRoot): void {
    const oldTrie = this.activeTrie;
    // 原子性指標指派(在 Go 或 C++ 中為 atomic.StorePointer)
    this.activeTrie = newTrieSnapshot;

    // 釋放舊樹記憶體或等待 GC 回收
    oldTrie.destroy();
  }
}- 獨立離線建樹:背景工作執行緒(Trie Builder)從 DB 或 Flink 快照讀取最新的關鍵詞評分,在背景構建一棵全新的唯讀 Trie 樹;
- 原子指標替換(Pointer Swap):新樹構建完成後,透過一條 CPU 原子指令將
activeTrie指針指向新樹; - 零中斷與零鎖開銷:整個替換過程耗時僅幾奈秒,在線服務讀取線程甚至完全感知不到切換動作,兼顧了數據新鮮度與極致的讀取吞吐量。
5. 個人化與業務邊界考量
在真正的商業級產品中,自動補全絕不僅僅是全網熱度排序:
5.1 個人化搜尋歷史優先級(Personalization)
使用者往往有重複搜尋自己關注項目的習慣:
- 混合策略(Hybrid Merging): 前端從 Local Storage 讀取該使用者的最近 3 筆本地歷史搜尋詞(標記時鐘圖標),與後端返回的 5 筆全網熱門詞進行合併;
- 優先展示:若個人歷史詞剛好匹配當前前綴,將其置頂顯示,並提供「刪除」歷史按鈕。
5.2 敏感詞過濾與法律合規(Safety Blacklist)
搜尋框不可避免會遭遇惡意灌票、違法內容或不雅詞彙:
- 布隆過濾器(Bloom Filter)快篩:在 Trie 節點返回前,先透過記憶體中的布隆過濾器過濾黑名單詞彙;
- 冷啟動保護:新詞進入 Top-K 之前,必須經過審核規則或最低頻次閾值防禦,杜絕駭客透過機器人腳本洗榜。
6. 總結與架構決策清單
| 架構層級 | 採用的技術與策略 | 解決的核心痛點 | 帶來的效能增益 |
|---|---|---|---|
| 演算法內核 | Top-K 前綴預存字典樹(Trie) | 消除子樹遍歷與運行時排序 | 查詢複雜度由 O(p + n) 降至 O(p)(< 1ms) |
| 客戶端層 | 50ms 防抖 + 本地記憶體快取 | 消除頻繁打字引發的重複請求 | 降低前端 40% 瞬時調用 |
| 邊緣層 | CDN 邊緣快取(Top 1~2 字母前綴) | 吸收全球海量重複短前綴流量 | 吸收 80% 全球高頻請求,邊緣響應 < 15ms |
| 服務層 | 一致性雜湊 + 二級前綴分片 | 解決首字母分片導致的熱點傾斜 | 叢集水平擴展,各節點負載完全均衡 |
| 資料流 | Flink 串流衰減評分 + 雙緩衝原子替換 | 數據熱度更新時引發的讀寫鎖阻塞 | 兼顧數分鐘級數據新鮮度與零鎖讀取吞吐 |
透過上述層層遞進的防護與專用資料結構,我們將一個原本可能拖垮資料庫的千萬級高頻搜尋場景,轉化為具備毫秒級超低延遲、無鎖高併發且兼顧動態熱搜的現代化企業級架構。