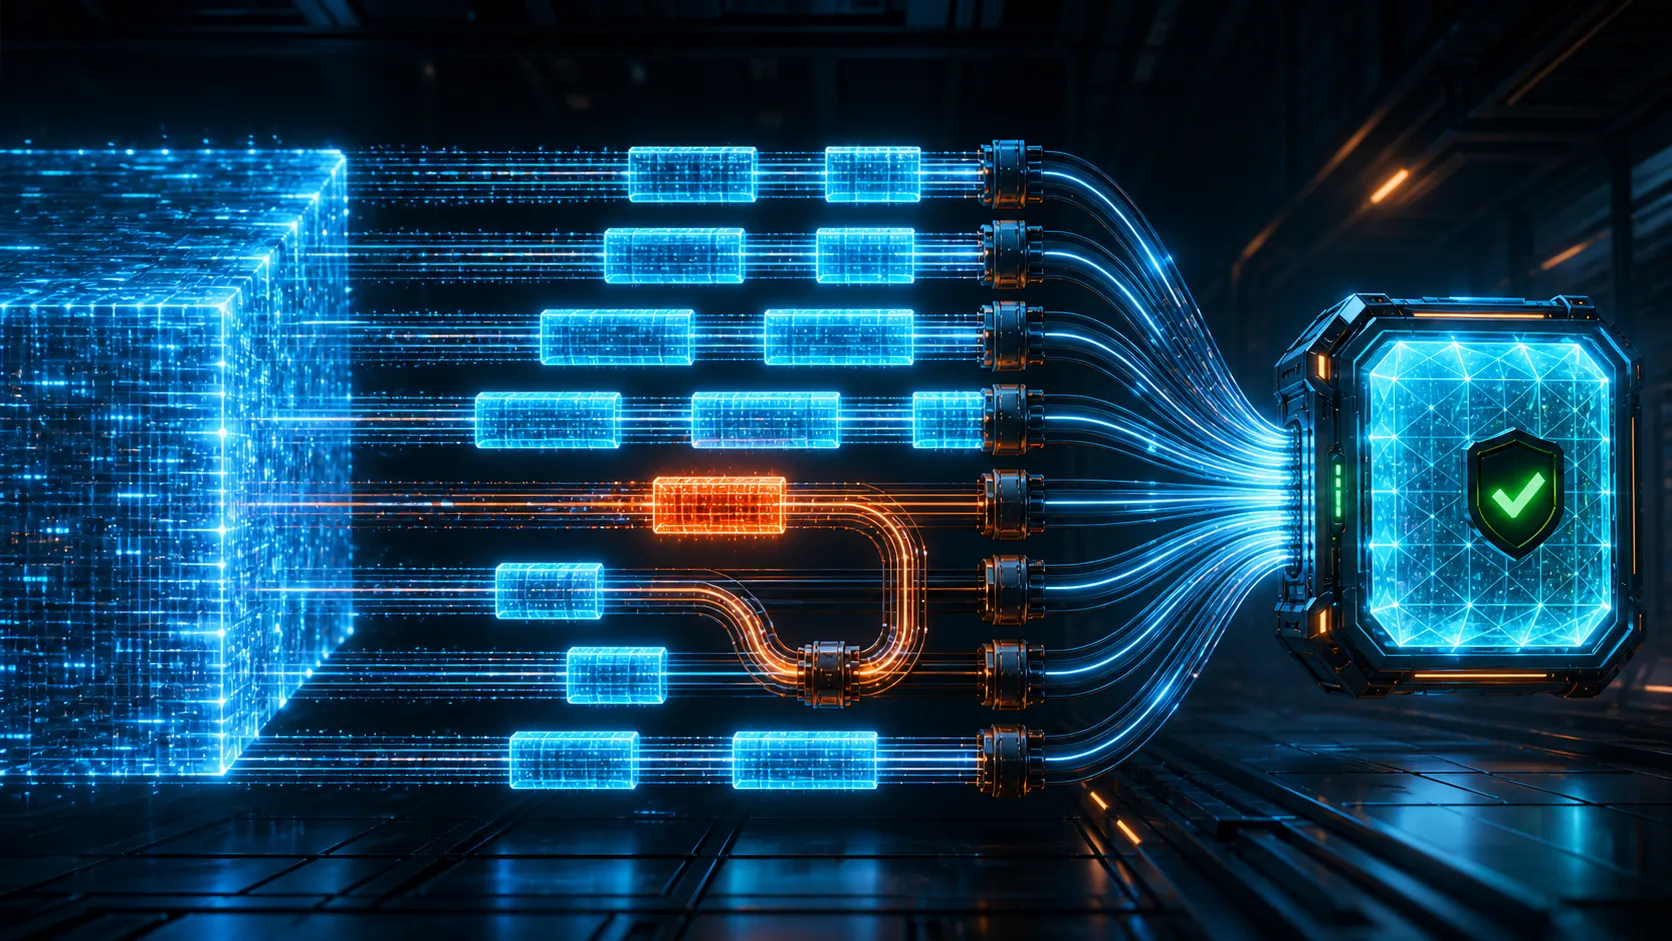
在雲原生與海量資料處理領域,上傳數十 GB 甚至數 TB 的大檔案(如 4K 原始影音素材、大模型權重 Checkpoints、資料庫全量備份 dump)是極為常見的業務場景。
如果使用標準的 HTTP PUT Object 單次傳輸方式上傳一個 50 GB 的檔案,只要在傳輸至 99% 時遭遇一次短暫的網路抖動、TCP 逾時或連線中斷,整個連線就會徹底失敗,客戶端必須從 0% 全部重新上傳。這不僅造成網路頻寬的極大浪費,更讓傳輸成功率隨檔案大小呈指數級暴跌。
為了解決大檔案上傳的可靠性與傳輸效率問題,AWS S3 及其相容物件儲存(如 Google Cloud Storage、MinIO、Cloudflare R2)設計了一套高度工程化的架構協議:分段上傳(Multipart Upload,簡稱 MPU)。
本文將從協定規範、客戶端平行分塊上傳管線、斷點續傳狀態機到 S3 內部零拷貝中繼資料合併,深度拆解其全鏈路架構。
S3 分段上傳架構全景圖
以下是從檔案分塊、初始化取得 UploadId、多線程並行傳輸、中斷後續傳探測到 S3 最終合併物件的完整架構拓撲:
1. 為什麼需要分段上傳?
1.1 單次 PUT 上傳的極限與瓶頸
- 單一連線無法榨乾上行頻寬:受限於單一 TCP 連線的滑動視窗(Window Size)與擁塞控制演算法(如 CUBIC/BBR),單線程傳輸無法充分利用千兆/萬兆光纖頻寬。
- 記憶體溢出(OOM)風險:伺服器若需在記憶體中緩衝整個物件進行校驗或加密,巨型檔案會直接吃滿 RAM。
- 錯誤復原成本極高:50 GB 檔案在 49.9 GB 處失敗,重試代價是再次傳輸完整的 50 GB。
1.2 S3 Multipart Upload 規範限制
AWS S3 對分段上傳制定了精確的邊界規範:
- 物件大小範圍:5 MB 到 5 TB。
- 分片大小限制(Part Size):5 MB 到 5 GB(最後一個分片可以小於 5 MB)。
- 最大分片數量:最多允許 10,000 個分片(Part Numbers: 1 ~ 10,000)。
- 計算公式:若要上傳 5 TB 檔案,最小分片大小為
5 TB / 10,000 ≈ 524 MB。
2. S3 分段上傳三階段標準協議
分段上傳將一個龐大的傳輸任務解耦為三個標準的 REST API 階段:
1. 初始化上傳會話
• 客戶端呼叫 POST /bucket/file?uploads。
• S3 返回全域唯一 UploadId,客戶端將其持久化至本地(IndexedDB/SQLite),作為斷點續傳的 Session 錨點。
2. 多執行緒並行分段上傳
• 檔案切割為多個 Part(例如每塊 64MB),多線程同時發送 PUT Part N。
• S3 持久化分片後返回 ETag 雜湊簽名。
• 斷點續傳關鍵:任何單一分片失敗僅重試該分片,其餘成功分片完全不受影響!
3. 完成合併發布
• 客戶端提交依照 PartNumber 嚴格升序排序的清單。
• 呼叫 CompleteMultipartUpload 請求。
✅ 零拷貝中繼資料指針組裝
S3 不做繁重的物理硬碟搬移,僅在分散式中繼資料庫建立指針樹,毫秒級瞬間發布完整 Object!
2.1 階段一:初始化(Initiate Multipart Upload)
客戶端發起 CreateMultipartUpload 請求,S3 在元數據庫中建立該上傳任務的會話記錄,並返回一個全域唯一的字串 UploadId。
在呼叫 Complete 或 Abort 之前,該 UploadId 會一直保持有效。
2.2 階段二:分段並行上傳(Upload Part)
- 客戶端將檔案按固定大小(如 64 MB)切分為多個 Part。
- 啟動 Worker 執行緒池,並行發起多個 HTTP
PUT請求,附帶partNumber與uploadId。 - S3 每接收並持久化一個分片,會在 HTTP Response Header 中返回該分片的
ETag(通常為該分片內容的 MD5 雜湊值)。 - 斷點續傳關鍵:如果 Part 3 傳輸失敗,客戶端只需針對 Part 3 進行指數退避重試,已經成功上傳的 Part 1、Part 2 完全不受影響!
2.3 階段三:完成組裝(Complete Multipart Upload)
當所有分片上傳完畢,客戶端發送 CompleteMultipartUpload 請求,Body 中包含一個按照 PartNumber 嚴格升序排序的清單:
<CompleteMultipartUpload>
  <Part>
    <PartNumber>1</PartNumber>
    <ETag>"b10a8db164e0754105b7a99be72e3fe5"</ETag>
  </Part>
  <Part>
    <PartNumber>2</PartNumber>
    <ETag>"1b2cf535f27731c974343645a3985328"</ETag>
  </Part>
</CompleteMultipartUpload>
S3 驗證清單無誤後,將分片組裝為最終對外可見的單一 Object,並產生最終的複合 ETag。
3. 客戶端並發分塊與斷點續傳引擎實作
在前端或客戶端 SDK 中,為了實現高可用與斷點續傳,通常會構建一個狀態機管理模組:
// S3 分段平行上傳引擎核心架構
interface PartUploadTask {
  partNumber: number;
  startByte: number;
  endByte: number;
  etag?: string;
  status: "PENDING" | "UPLOADING" | "COMPLETED" | "FAILED";
}

class ResumableS3Uploader {
  private file: File;
  private uploadId: string | null = null;
  private partSize = 10 * 1024 * 1024; // 10 MB per part
  private concurrency = 4; // 同時 4 個並行 Worker

  async start() {
    // 1. 檢查本機 IndexedDB / SQLite 是否有未完成的 uploadId
    this.uploadId = await this.loadSavedUploadId();

    if (!this.uploadId) {
      this.uploadId = await this.initiateS3Upload();
      await this.saveUploadState();
    }

    // 2. 向 S3 查詢已成功接收的分片 (ListParts 探測)
    const uploadedParts = await this.fetchAlreadyUploadedParts(this.uploadId);

    // 3. 建立並過濾出尚未完成的分片任務隊列
    const tasks = this.buildPartTasks(uploadedParts);

    // 4. 透過並行 Worker 池執行上傳
    await this.runWorkerPool(tasks);

    // 5. 提交 Complete 請求完成合併
    await this.completeUpload(tasks);
    await this.clearSavedUploadState();
  }
}
4. 數據完整性防禦與 S3 複合 ETag 計算
在傳輸數十 GB 的資料時,網路設備(路由器、交換機)可能會發生微小的位元翻轉(Bit Flip)。S3 透過多層校驗機制確保絕對的數據完整性:
4.1 Content-MD5 / SHA256 校驗
客戶端在發送每個 UploadPart 請求時,在 Header 中附帶 Content-MD5。S3 伺服器在接收串流的同時動態計算 MD5,若計算值與 Header 不符,立即拒絕並回傳 400 Bad Digest。
4.2 S3 複合 ETag 的生成原理
對於單次 PUT 上傳的物件,其 ETag 就是全檔案的 MD5 雜湊值;但對於 Multipart Upload 生成的物件,S3 的 ETag 採用了特殊的複合計算公式:
ETag = Hex( MD5( Binary(MD5_1) + Binary(MD5_2) + ... + Binary(MD5_N) ) ) + "-" + N例如 ETag 為 "c8b598...-4",其中後綴 -4 明確標示該物件是由 4 個分段組裝而成。客戶端可以使用相同演算法在本地校驗整個檔案的一致性。
5. S3 伺服器內部合併機制:邏輯中繼資料指針合併
許多工程師誤以為在呼叫 CompleteMultipartUpload 時,S3 伺服器會在磁碟上將 500 個 100MB 的物理檔案讀出並寫入一個新的 50GB 物理檔案中。
如果這樣做,S3 每次 Complete 上傳都要耗費數十秒做磁碟 I/O 拷貝,且會產生嚴重的 I/O 寫入放大!
在現代物件儲存架構(如 S3、MinIO)中,Complete 過程採用了零拷貝中繼資料指針合併(Zero-Copy Metadata Linking):
- 每個分段在寫入時,已經以底層區塊或糾刪碼(Erasure Coding)的形式分散儲存在各個 Storage Node 上。
CompleteMultipartUpload請求只會在分散式元數據資料庫(Metadata Key-Value Store)中更新該 Object 的結構:{ "object_key": "large.iso", "total_size": 52428800000, "parts": [ { "part": 1, "size": 104857600, "node_block_ref": "node-101/blk-8812" }, { "part": 2, "size": 104857600, "node_block_ref": "node-204/blk-9931" } ] }- 整個 Complete 請求在 幾毫秒內 即可完成,隨後該 Object 立即對全球用戶開放讀取(GET Range 請求會根據 Offset 映射到底層各個 Part 指針)。
6. 生產維運暗坑:未完成分段導致的儲存費用黑洞
在生產環境中,分段上傳有一個致命的維運陷阱:孤兒分片(Incomplete Multipart Uploads)。
- 若某個客戶端發起了
CreateMultipartUpload,上傳了 40 GB 的分片後意外崩潰且永遠沒有發起Complete或Abort。 - 這些已經上傳的 40 GB 分片在 S3 Bucket 中對用戶不可見(不會出現在 ListObjects 中),但 AWS S3 會持續針對這些分段收取標準儲存費用!
6.1 解決方案:配置 S3 生命週期策略(Lifecycle Rule)
在每個 S3 Bucket 上,必須強制開啟 AbortIncompleteMultipartUpload 生命週期規則:
{
  "Rules": [
    {
      "ID": "AutoAbortIncompleteMultipartUploads",
      "Status": "Enabled",
      "Filter": {},
      "AbortIncompleteMultipartUpload": {
        "DaysAfterInitiation": 7
      }
    }
  ]
}
設定此規則後,任何超過 7 天未完成組裝的過期分片將由 S3 後台自動刪除,徹底杜絕無效帳單膨脹。
總結
S3 Multipart Upload 透過三階段協定解耦、多線程平行傳輸、粒度化斷點重傳與零拷貝元數據組裝,為巨型大檔案傳輸提供了工業級的高可靠性與效能保障。
掌握分段大小規劃、客戶端並發狀態機設計、複合 ETag 校驗與生命週期自動清理,是構建現代高可用雲端資料傳輸通道的核心必備功底。