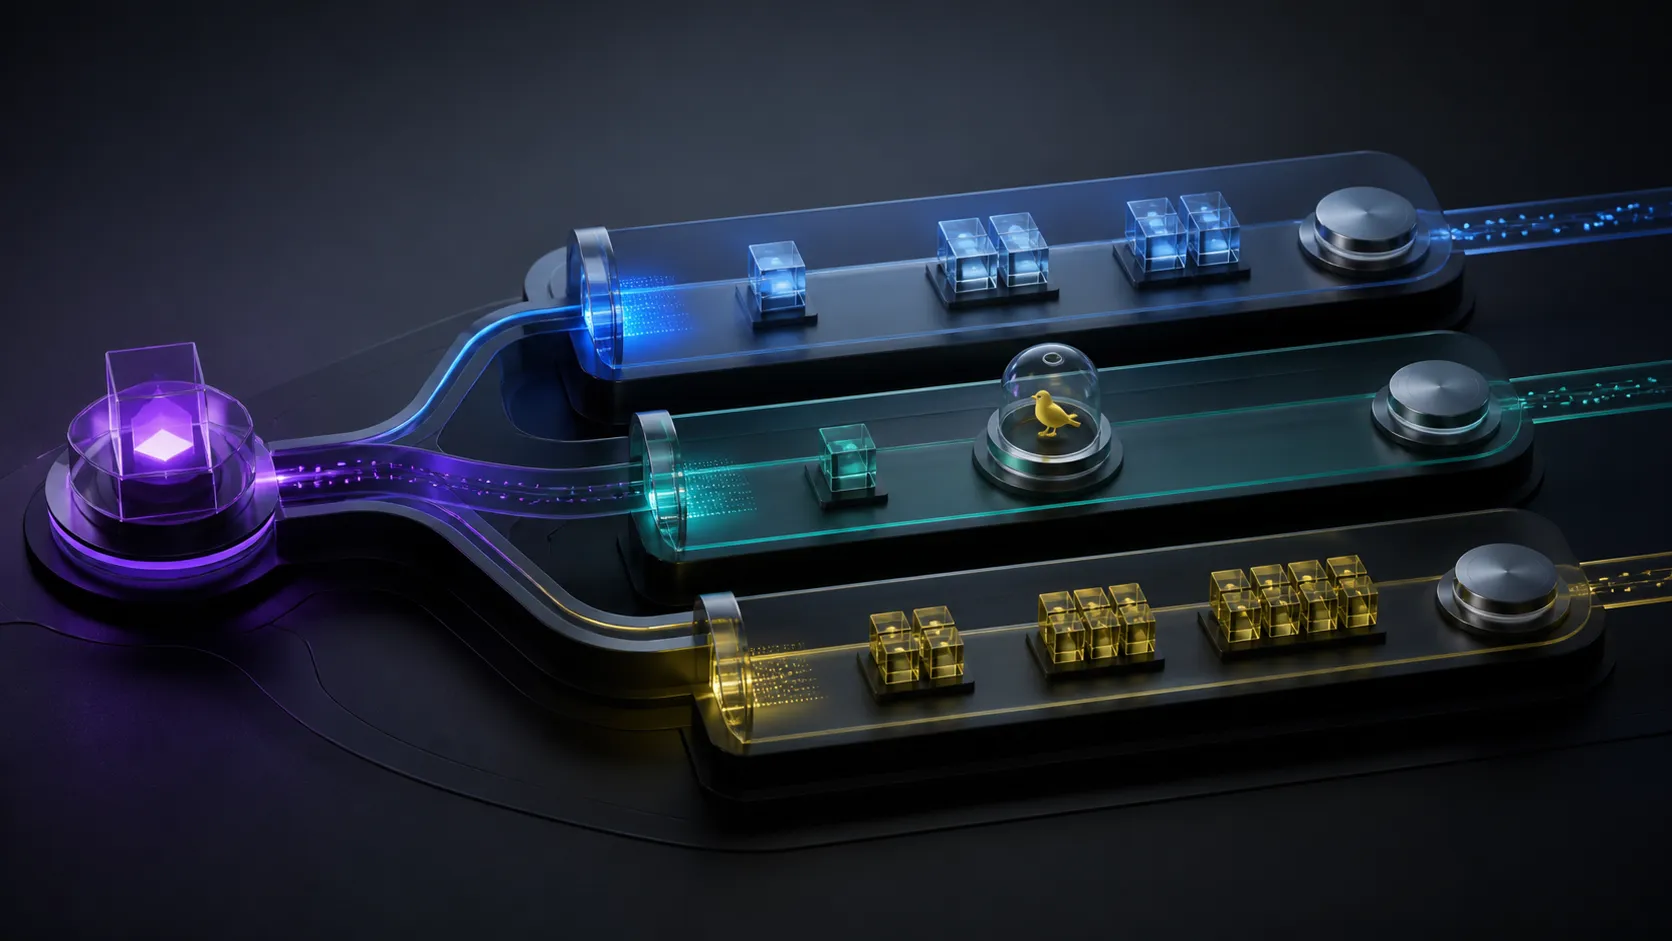
在網際網路服務的日常維運中,「上線發布」往往是引發系統故障(P0/P1 級 Incident)最高發的危險時刻。
早期的發布往往需要維運團隊在半夜三更進行停機維護。然而,現代全球化服務要求的是 7x24 小時 99.99% 的高可用性。如何保證在程式碼升級、配置變更與資料庫結構變更時,全站使用者完全零感知、零停機(Zero-Downtime Deployment)?
當新版本代碼隱藏著潛在的記憶體洩漏或效能劣化時,系統又如何做到毫秒級自動阻斷與秒級自動回滾(Automated Rollback)?
本文將全面剖析四大經典部署策略的底層拓撲、自動化金絲雀分析(ACA)以及資料庫平滑遷移架構。
1. 四大發布策略全景對決
| 評估維度 | Recreate (重建) | Rolling Update | Blue-Green (藍綠) | Canary (金絲雀) |
|---|---|---|---|---|
| 服務停機時間 | 存在明確停機窗口 | 零停機 (逐台替換) | 零停機 (瞬間切換) | 零停機 (漸進引流) |
| 額外伺服器成本 | 零 | 極低 (多1~2個Pod) | 需 100% 雙倍資源 | 低 (多 5%~10% 資源) |
| 回滾速度 | 緩慢 (需重新部署) | 較慢 (需反向滾動) | 極速 (秒級指針切換) | 極速 (關閉引流權重) |
| 新舊版本共存狀態 | 否 (全死後全生) | 是 (滾動期間共存) | 否 (流量瞬間切換) | 是 (長週期共存驗證) |
| 故障影響半徑 | 100% 全量使用者 | 部分使用者 | 100% (切換瞬間) | 極小 (僅1%~5%流量) |
| 適用場景 | 開發/測試環境 | 常規無狀態微服務 | 關鍵核心系統/大重構 | 億級高併發核心服務 |
2. 藍綠部署(Blue-Green)vs. 金絲雀發布(Canary)
2.1 藍綠部署架構(Blue-Green Deployment)
- 環境準備:同時維護兩套硬體規格完全相同的獨立生產叢集:藍環境(Blue - 當前線上運行的舊版本) 與 綠環境(Green - 部署了全新程式碼的新版本)。
- 驗證與切換:在綠環境中執行全套內部端到端驗證;驗證無誤後,透過負載平衡器(如 AWS ALB 或 Cloudflare)在秒級瞬間將全域流量從藍環境切換至綠環境。
- 秒級回滾:若切換後發現重大異常,只需將負載平衡器指標指回藍環境,立即恢復線上服務。
2.2 金絲雀發布(Canary Release)
如同早期煤礦工人帶著金絲雀下井以探測瓦斯氣體,金絲雀發布先將極小比例的線上真實流量(如 1%~5%)路由至新版本:
3. Netflix 自動化金絲雀分析(Kayenta ACA)
手動靠工程師盯著 Grafana 儀表板判斷新版本是否正常,不僅效率低且極易漏看細微的性能衰退。Netflix 開源了 Kayenta 自動化金絲雀分析引擎。
3.1 曼-惠特尼 U 檢驗(Mann-Whitney U Test)
Kayenta 並非簡單地比對「平均值」,而是採用非參數統計學檢驗:
- 同時採集 Baseline(基線組) 與 Canary(金絲雀組) 在完全相同時間區間內的時序指標樣本。
- 透過統計檢驗判斷 Canary 的指標分佈是否與 Baseline 存在顯著差異(Statistically Significant Difference)。
- 計算綜合健康評分(例如總分 100 分,低於 75 分立即觸發自動回滾)。
4. 終極難題:資料庫結構變更的「擴展-收縮(Expand-Contract)」模式
無狀態服務可以隨意藍綠切換,但資料庫只有一份。若新版本程式碼需要修改資料表欄位(例如將 full_name 拆分為 first_name 與 last_name),直接執行 ALTER TABLE 會導致舊版本程式碼瞬間崩潰。
必須採用 擴展-收縮模式(Expand-Contract Pattern / Parallel Run):
5. 架構實戰總結
- 標準微服務部署:一律採用 Kubernetes Rolling Update + 嚴格的 Readiness/Liveness 探針。
- 核心支付與交易系統:採用 Canary 金絲雀發布 + Kayenta 自動化指標驗收,將風險半徑控制在 1% 範圍內。
- 資料庫變更:嚴格遵守 Expand-Contract 雙寫相容模式,徹底消滅資料庫結構變更帶來的停機事故。